News · Logiciel
Reflection Beam : un modèle ouvert américain de 501 milliards de paramètres
Reflection AI présente Beam le 5 octobre 2026 : MoE de 501 milliards de paramètres (23 milliards actifs), texte seul, licence Apache 2.0. Accès sur liste d’attente, poids promis en octobre. Scores proches de GLM 5.2, derrière Kimi K3, selon l’éditeur.
Le 5 octobre 2026, la start-up américaine Reflection AI a présenté Beam, son premier modèle à poids ouverts, dans un billet de blog (ouvre reflection.ai dans un nouvel onglet). Le modèle compte 501 milliards de paramètres, dont 23 milliards actifs, et ne traite que du texte. Il n’est pas encore téléchargeable : Reflection l’ouvre d’abord à un groupe restreint, sur liste d’attente, et promet les poids sous licence Apache 2.0 plus tard en octobre.
Info
Contrôle du 7 octobre 2026. Source primaire lue : billet d’annonce de Reflection AI (ouvre reflection.ai dans un nouvel onglet). Contexte presse : Pure AI (ouvre pureai.com dans un nouvel onglet). Non confirmé à cette date : la date exacte de publication des poids, un éventuel prix d’API, la disponibilité chez des hébergeurs européens et tout test indépendant. Tous les scores cités ci-dessous viennent de Reflection.
Ce qu’est Beam
Beam est un modèle « mélange d’experts » (MoE) : il contient 501 milliards de paramètres, mais n’en sollicite que 23 milliards pour chaque token produit. Résultat : beaucoup de connaissances stockées, pour un coût de calcul par réponse proche d’un modèle bien plus petit. Reflection annonce une fenêtre de contexte d’un million de tokens et un réglage de l’effort de raisonnement, pour choisir entre réponses courtes et réflexion plus longue.
Le modèle vise surtout le code et les tâches d’agent (enchaîner des actions avec des outils). Selon Reflection, il a été pré-entraîné sur 23 800 milliards de tokens avec 6 144 GPU NVIDIA GB300, puis affiné par apprentissage par renforcement sur 10 500 GB300 pendant quatre semaines.
Des chiffres d’éditeur à lire avec prudence
Reflection présente Beam comme compétitif avec GLM 5.2 et proche de Qwen 3.8-Max en code et en agents, tout en reconnaissant que Kimi K3 reste devant. Son propre tableau le confirme, sans le placer en tête :
- Terminal Bench 2.1 : Beam 80,1, GLM 5.2 81,0, Qwen 3.8 Max 86,6, Kimi K3 88,3, DeepSeek V4.1 Flash 90,6 ;
- SWE-Bench Pro v1 : Beam 65,5, GLM 5.2 62,1, Qwen 3.8 Max 67,7 ;
- Humanity’s Last Exam (sans outils) : Beam 36,2, Qwen 3.8 Max 43,6.
L’argument principal est l’efficacité. Reflection affirme obtenir des scores de raisonnement comparables à GLM-5.2 avec trois à quatre fois moins de calcul à l’inférence. La comparaison porte donc sur GLM-5.2 ; face à Qwen 3.8-Max, l’écart serait plus grand, mais il n’est pas chiffré. Surtout, il s’agit d’une estimation : paramètres actifs multipliés par le nombre de tokens générés, sans compter la lecture du prompt ni les coûts de service. Ce n’est pas une facture mesurée.
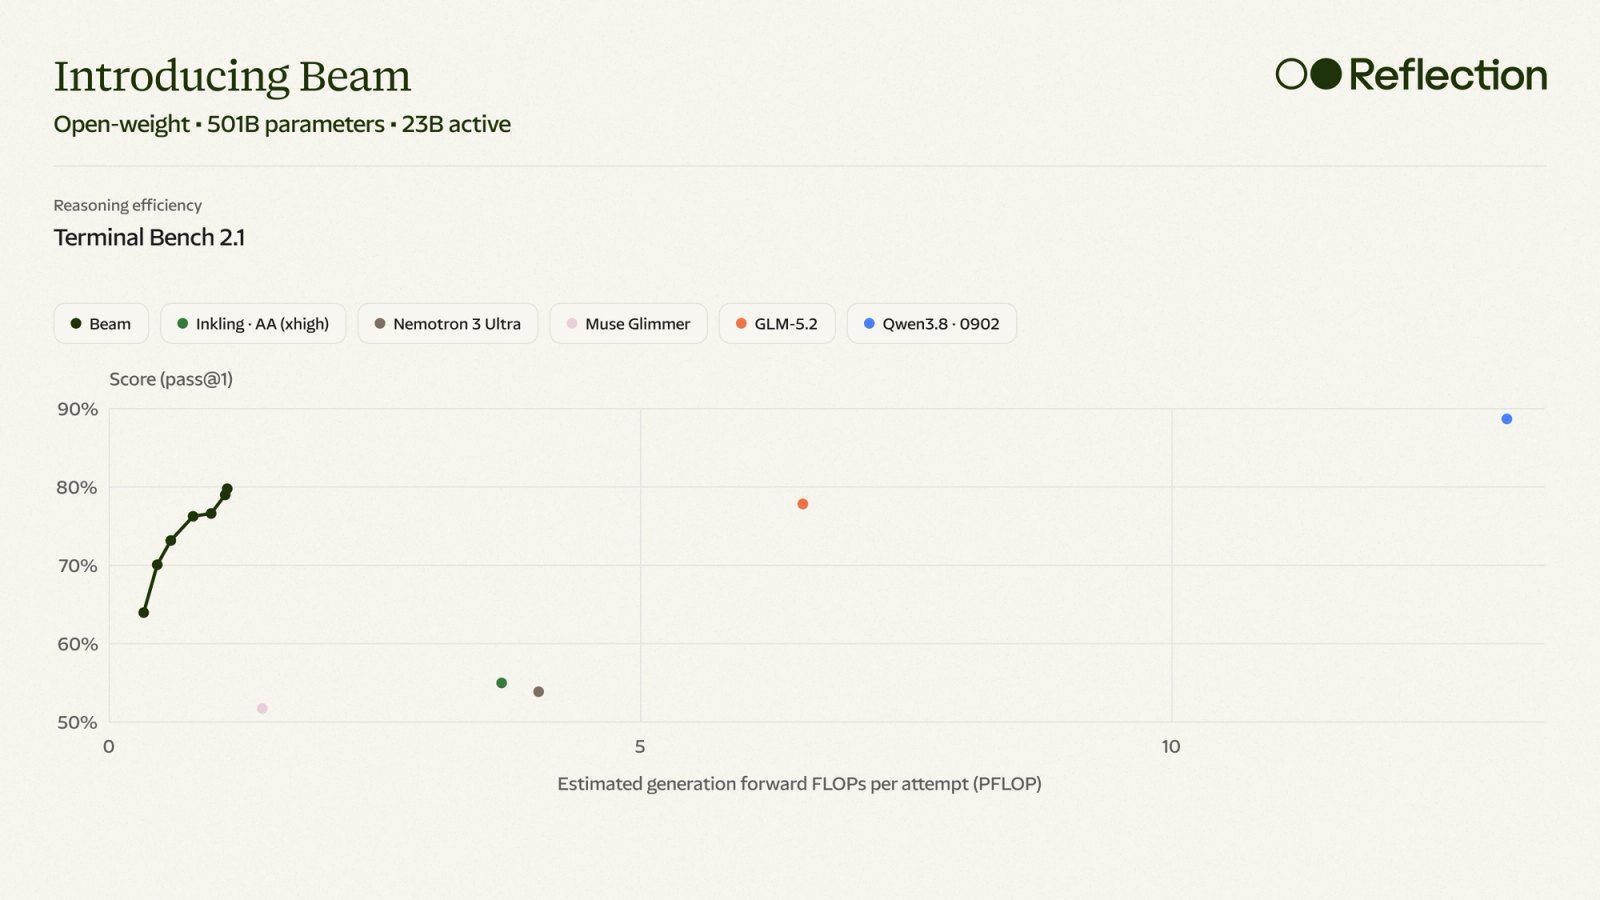
Crédit : Reflection AI (ouvre reflection.ai dans un nouvel onglet), graphique d’efficacité publié avec l’annonce, 5 octobre 2026.
La course des modèles ouverts
Ces derniers mois, les modèles ouverts les plus performants sont surtout chinois : DeepSeek, Qwen (Alibaba), Kimi (Moonshot) et GLM (Zhipu). Reflection revendique explicitement de faire avancer la frontière « occidentale » des poids ouverts. Selon Pure AI (ouvre pureai.com dans un nouvel onglet), l’entreprise a été fondée par d’anciens chercheurs de Google DeepMind et est soutenue par NVIDIA.
Le calendrier rappelle celui de Mistral Large 4, annoncé le 6 octobre avec des poids promis pour fin octobre. Différence notable : Reflection annonce déjà sa licence, Apache 2.0, qui autorise l’usage commercial et la modification. Côté prix, la référence reste chinoise : DeepSeek V4.1-Flash est facturé 0,15 $ le million de tokens en entrée, hors pointe. Reflection n’a donné aucun tarif.
Pour l’IA locale, il faut rester réaliste. D’après notre calcul, les seuls poids de Beam occupent environ 500 Go en 8 bits et 250 Go en 4 bits : c’est hors de portée d’un PC de jeu, même bien équipé. Beam vise des serveurs ou de très grosses stations de travail.
Notre lecture. Analyse. Beam arrive avec une licence claire et des scores honnêtes, puisque Reflection ne se place pas devant les meilleurs modèles chinois. Son pari, faire autant avec moins de calcul, intéressera les entreprises qui hébergent elles-mêmes leurs modèles. Mais tant que les poids ne sont pas publiés et testés hors de chez Reflection, ce n’est qu’une promesse.
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.