News · Logiciel
Abonnements IA : enquête sur le cycle lancement, nerf, reset
Un modèle sort, il est brillant et ne consomme rien. Quelques semaines plus tard, il « devient bête » et le quota fond. On a repris les dossiers Anthropic et OpenAI 2025-2026 : aucune preuve de dégradation volontaire, mais une longue liste de changements silencieux reconnus après coup.
Le scénario est devenu si régulier qu’il a un nom sur X : la « Post-Launch Lobotomy ». Un modèle sort. Il est brillant, le quota semble inépuisable, les éditeurs offrent des resets et des boosts. Deux à six semaines plus tard, les forums se remplissent : le modèle est « devenu bête », la barre d’usage fond en une matinée. L’éditeur dément. Puis, souvent, il publie un postmortem, reconnaît un ou plusieurs changements, offre un reset. Et le cycle recommence au modèle suivant.
On a repris les dossiers Anthropic et OpenAI de 2025 et 2026, en ne gardant que ce qui est daté et sourcé : billets officiels, tweets des responsables produit, tickets GitHub, mesures publiées. La conclusion est moins complotiste que les forums, et moins rassurante que les éditeurs. Aucune preuve de dégradation volontaire du modèle. Mais une longue liste de changements silencieux, reconnus après coup, qui ont bel et bien dégradé ce que payaient les abonnés.
Info
Contrôle du 27 septembre 2026. Sources primaires lues : postmortems Anthropic de septembre 2025 (ouvre anthropic.com dans un nouvel onglet) et d’avril 2026 (ouvre anthropic.com dans un nouvel onglet), tweets de @ClaudeDevs (ouvre x.com dans un nouvel onglet) et de Thibault Sottiaux (Codex, OpenAI), tickets GitHub anthropics/claude-code et openai/codex, fils Hacker News. Reddit n’a pas pu être consulté : aucune citation Reddit ici. Articles liés : quotas Codex, fin du boost Claude Code, qualité d’Astra, resets d’OpenAI.
Le cycle, en cinq temps
1. Le lancement généreux
Au lancement, les éditeurs ouvrent les vannes. Anthropic relève les plafonds hebdomadaires de Claude Code de 50 % le 13 mai 2026, une promotion prolongée cinq fois jusqu’au 13 septembre. OpenAI supprime la limite de cinq heures pour les abonnés Plus à la mi-juillet et multiplie les resets de quotas à chaque palier d’utilisateurs. Le 3 septembre, jour de sortie de GPT-6 Astra, Sottiaux promet un reset en banque par jour d’attente.
C’est pendant cette fenêtre que se forme l’impression de référence : « ce modèle ne consomme rien ». Elle est en partie vraie, et en partie un effet des promotions.
2. Les premières plaintes
Puis les témoignages arrivent. Le 10 septembre, une semaine après Astra, synthwavedd écrit (ouvre x.com dans un nouvel onglet) : « Astra feels significantly dumber for me today… Was only a matter of time before The Post-Launch Lobotomy™️ ». Le lendemain, Dax Raad, créateur d’Opencode, constate (ouvre x.com dans un nouvel onglet) que son équipe revient à Sol : « our effective spend looks doubled ».
Chez Anthropic, le cas le plus documenté date d’avril. Stella Laurenzo, ingénieure chez AMD, ouvre le ticket #42796 (ouvre github.com dans un nouvel onglet) : « Claude has regressed to the point it cannot be trusted to perform complex engineering. » Elle a analysé 6 852 sessions et 17 871 blocs de raisonnement : la longueur médiane visible est passée d’environ 2 200 à 600 caractères.
Le 2 juillet, BridgeMind publie (ouvre x.com dans un nouvel onglet) « FABLE 5 CAME BACK NERFED » avec ses propres bancs : débogage de 86,2 à 25,9, refactoring de 73,6 à 38,4.
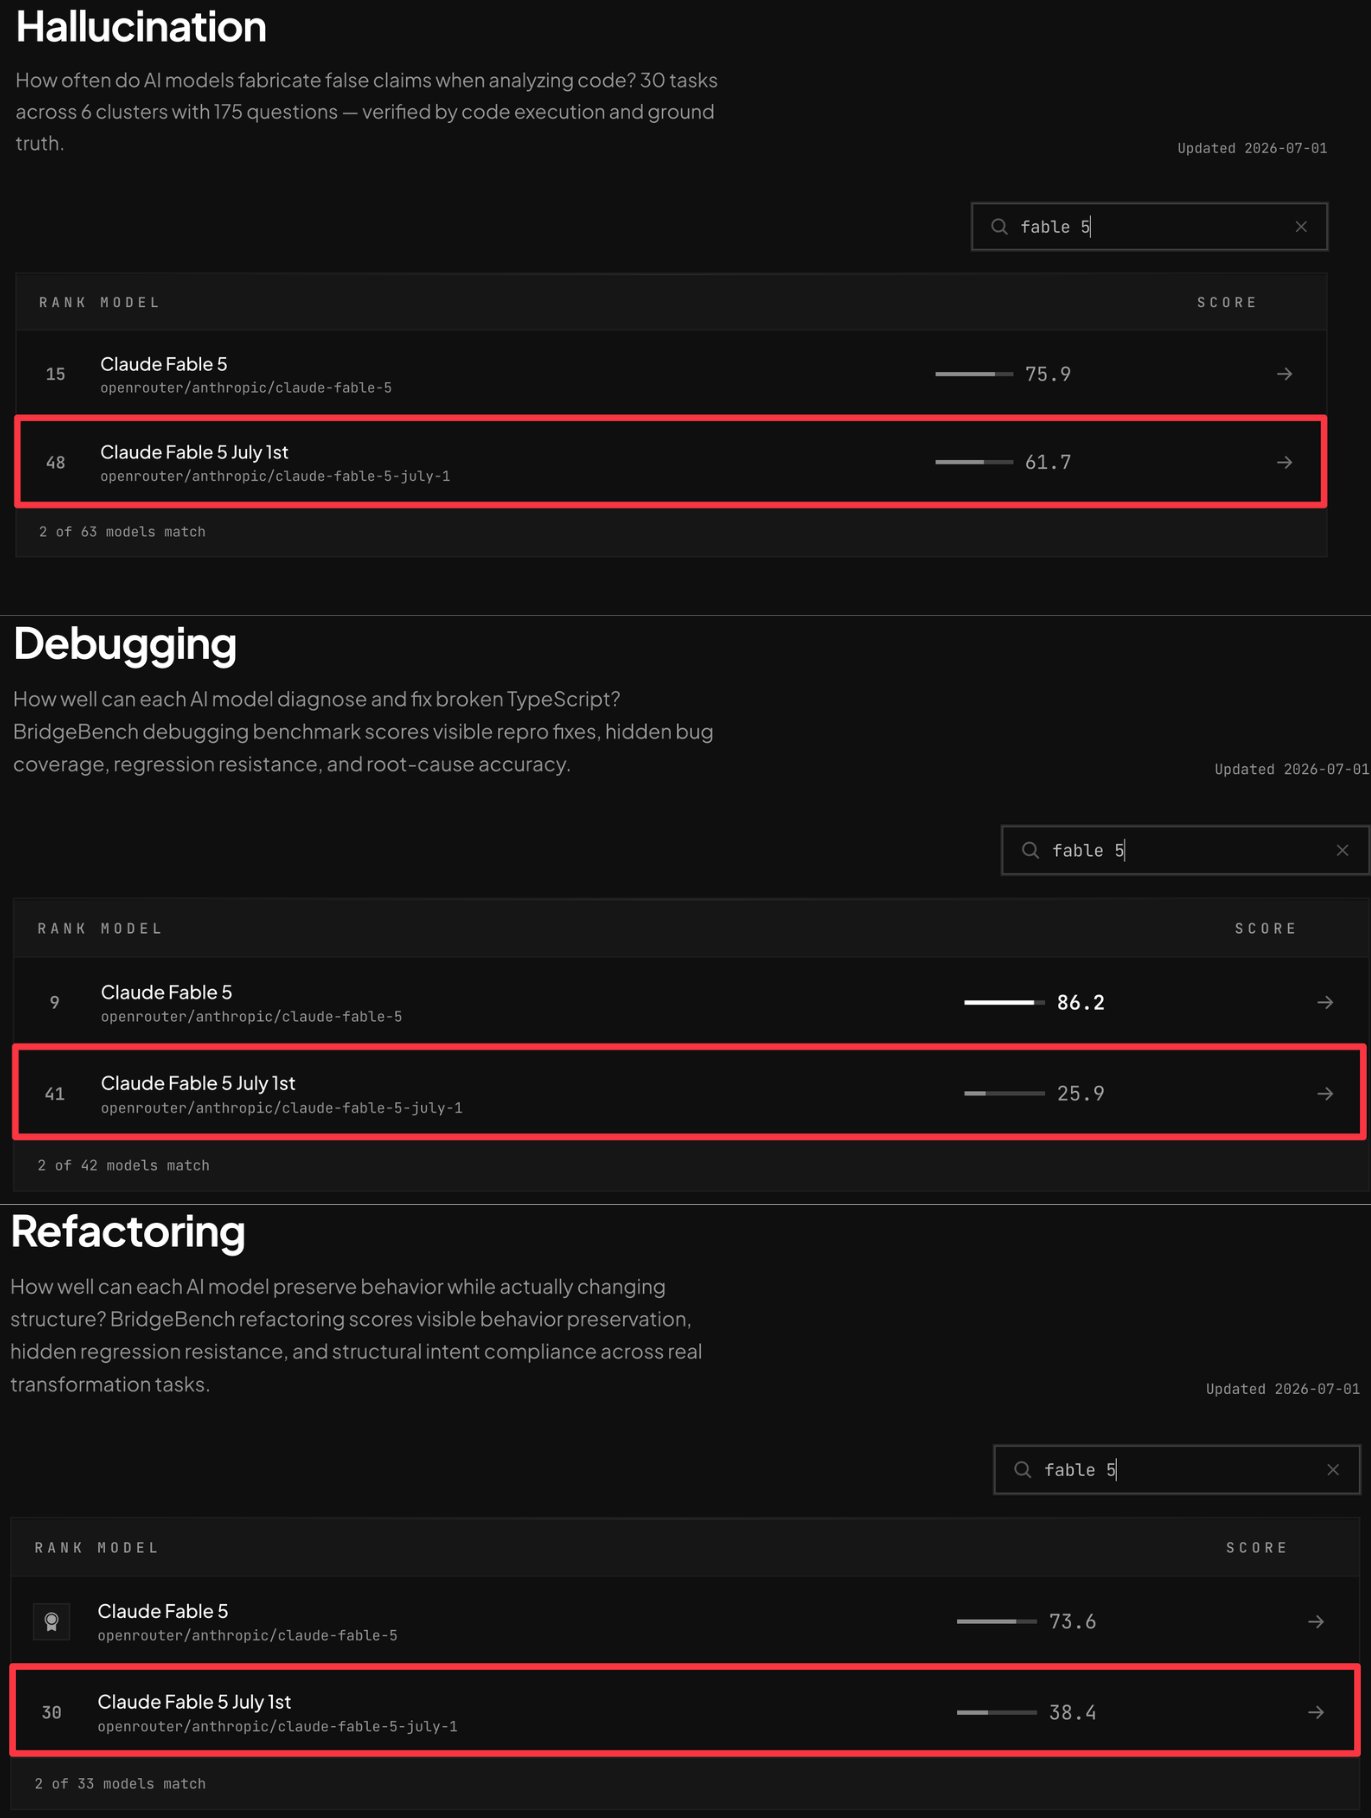
Crédit : BridgeMind (@bridgemindai) (ouvre x.com dans un nouvel onglet), 2 juillet 2026. Banc communautaire, pas une mesure Anthropic.
3. Le démenti
Les éditeurs répondent d’abord qu’ils n’ont rien changé. Le 6 avril, sous le ticket de Stella Laurenzo, un utilisateur demande à Boris Cherny, responsable de Claude Code, de confirmer qu’aucun changement interne connu ne peut expliquer la régression. Sa réponse (ouvre github.com dans un nouvel onglet) tient en un mot : « Confirmed ».
Le 29 juillet, Sottiaux écrit (ouvre x.com dans un nouvel onglet) pour Codex : « we have not reduced usage on any subscription plans ». Et la ligne de fond d’Anthropic ne varie pas depuis 2025 : « We never reduce model quality due to demand, time of day, or server load. »
4. L’aveu partiel
Quelques semaines plus tard, les postmortems arrivent. Et ils décrivent des changements bien réels.
Le 23 avril 2026, Anthropic reconnaît trois changements (ouvre anthropic.com dans un nouvel onglet) dans Claude Code :
- le 4 mars, l’effort de raisonnement par défaut passe de
highàmedium, pour réduire la latence ; annulé le 7 avril ; - le 26 mars, un changement censé vider l’ancien raisonnement des sessions inactives depuis une heure le vide à chaque tour, ce qui rend Claude « oublieux » ; corrigé le 10 avril ;
- le 16 avril, une consigne de concision ajoutée au prompt système dégrade la qualité du code ; annulée le 20 avril.
Le 6 avril, jour du « Confirmed », deux de ces trois changements étaient donc en place. Le billet précise : « We never intentionally degrade our models ». Les deux phrases sont compatibles. Le modèle n’a pas changé. Ce que l’abonné recevait, si. Sur Hacker News, le jour du billet, jwr résume le grief : « secretly changing things that are likely to decrease performance ».
Chez OpenAI, même mouvement. Le 29 juillet, le même tweet qui dément toute baisse reconnaît que Sol « can use more tokens than High did on GPT-5.5 », que les tests avant lancement regardaient la médiane et ont raté la longue traîne, et ajoute : « We should have recognized this sooner ». Le 22 août, Sottiaux admet (ouvre x.com dans un nouvel onglet) un taux d’accès au cache dégradé « for some users », qui « could explain that usage is draining somewhat faster ». Le 29 août, huit bugs de surconsommation, dont une boucle /goal qui a pu avaler jusqu’à 15 à 70 % d’un quota hebdomadaire. Le 12 septembre, pour Astra : des skills trop fréquentes, une expérience de gestion du contexte sur 4 000 à 5 000 comptes, et des « badly configured engines that resulted in a measured quality degradation ».
Côté Anthropic, le 30 juin, le redéploiement de Fable 5 ajoute un classifieur qui renvoie certaines requêtes vers Opus 4.8, un modèle plus ancien. Anthropic reconnaît qu’il signale trop souvent des requêtes bénignes de code et de débogage. C’est exactement ce que BridgeMind mesurait deux jours plus tard.
5. La compensation, puis le serrage
Chaque aveu est suivi d’un reset. Le 23 avril, Anthropic reset les limites de tous les abonnés. OpenAI en a fait un rituel : 55 resets recensés en un an par un tracker communautaire.
Puis vient le serrage. Le 25 août, OpenAI rétablit la limite de cinq heures pour Plus. Le 10 septembre, elle suspend les nouvelles souscriptions au Pro à 200 $. Le 29 août, Anthropic annonce la fin du boost et une hausse « permanente » de 25 %, puis précise dans le tweet suivant : « Compared to today, this works out to a 17% reduction in weekly limits on Claude Code. » La même phrase promet des changements qui « make it feel like you’re getting more from Claude ». Sur Hacker News, xingped y voit du « very weasely wording ». big_toast : « a lot of doublespeak, which I think undermines trust ».
Ce qui est prouvé, ce qui ne l’est pas
| Explication | Statut au 27 septembre |
|---|---|
| Effort de raisonnement abaissé par défaut | Reconnu par Anthropic (4 mars – 7 avril 2026) |
| Bugs de cache qui font fondre le quota | Reconnu par Anthropic (mars, puis Fable 5.1 corrigé en 2.1.260 le 3 septembre) et OpenAI (22 août) |
| Prompt système ou skills qui dégradent la sortie | Reconnu par Anthropic (16 avril) et OpenAI (12 septembre) |
| Moteurs d’inférence mal configurés | Reconnu par OpenAI (12 septembre) |
| Nouveau modèle plus gourmand à effort égal | Reconnu par OpenAI pour Sol (29 juillet) |
| Bascule vers un modèle plus ancien | Documenté : classifieur Fable 5 vers Opus 4.8 (30 juin) |
| Modèle quantifié ou remplacé en douce | Hypothèse de la communauté, aucune preuve |
| Limites qui varient selon la charge | Hypothèse, jamais démontrée ; les éditeurs parlent seulement de capacité tendue |
| Biais de perception après la hype | Plausible, avancé par une partie de la communauté |
Ce dernier point mérite d’être pris au sérieux. Le 11 septembre, Antikythera_0 répond (ouvre x.com dans un nouvel onglet) aux plaintes sur Astra : « It is as dumb as it was on launch ». Les premiers jours, on teste un modèle sur ses meilleurs cas ; ensuite, on l’utilise sur son travail réel. Une partie des « nerfs » est sans doute là. Mais la liste des changements reconnus montre qu’on ne peut plus balayer chaque plainte comme une impression.
Les mesures qui existent
La communauté a commencé à mesurer plutôt qu’à ressentir. Marginlab (ouvre marginlab.ai dans un nouvel onglet) fait tourner Claude Code chaque jour sur SWE-Bench-Pro ; une nouvelle base de référence Opus 5.5 est en cours depuis le 24 septembre. livenerf (ouvre github.com dans un nouvel onglet) suit Opus 5.5 depuis sa sortie avec un protocole déclaré à l’avance ; premier verdict vers le 24 octobre. IsItNerfed (ouvre isitnerfed.org dans un nouvel onglet) a signalé une dégradation le 19 février 2026, suivie d’un retour à la normale. Côté quotas, le Codex Quota Observatory (ouvre codex-quota.manetli.com dans un nouvel onglet) mesure la consommation d’un compte Pro.
Sur GitHub, les mesures individuelles s’accumulent. Le 4 septembre, ezmvidal décrit (ouvre github.com dans un nouvel onglet) des tokens pondérés en baisse de trois à quatre fois depuis début août, tout en touchant plus souvent la limite de cinq heures. Côté Codex, le méta-ticket #41220 (ouvre github.com dans un nouvel onglet) agrège les signalements de consommation anormale.
Pourquoi ça se répète
Le schéma n’est pas un complot. C’est la rencontre de trois contraintes.
La capacité. Un lancement attire un afflux que personne ne dimensionne parfaitement. Anthropic a écrit le 18 août que la capacité « may be tight ». OpenAI a fermé le 200 $ pour cause de demande « unprecedented ». Quand le calcul manque, on touche aux réglages : effort par défaut, gestion du contexte, cache, routage.
Le forfait opaque. Ni Anthropic ni OpenAI ne publient un quota en tokens. Anthropic publie des pourcentages, OpenAI des fourchettes qui « ne sont pas des plafonds fixes ». Un changement de réglage se traduit donc directement en quota plus court, sans ligne de facture pour le prouver.
Le cycle de sortie. Un nouveau modèle tous les un à deux mois chez chacun. Chaque lancement relance une promotion, chaque promotion fixe une référence trop haute, chaque fin de promotion ressemble à un nerf.
Ce que l’abonné peut faire
Trois réflexes, tirés des dossiers ci-dessus. Noter la version de l’outil et le réglage d’effort quand la qualité chute : les deux postmortems d’Anthropic et d’OpenAI tiennent à ces paramètres. Mesurer sa consommation sur une tâche répétable plutôt que sur une impression : c’est ce qui a fait avancer les tickets #42796 et #41220. Et comparer au prix API, où chaque token est facturé : c’est le seul régime où un « nerf » de quota se voit sur la facture.
Attention
Faits : trois changements Claude Code reconnus le 23 avril 2026, huit bugs de surconsommation Codex reconnus le 29 août, une dégradation de qualité Astra reconnue le 12 septembre, un classifieur Fable 5 vers Opus 4.8 reconnu le 30 juin, une baisse de 17 % des limites Claude Code chiffrée par Anthropic. Accusations non prouvées : modèle quantifié ou remplacé, limites dynamiques selon la charge. Les deux éditeurs affirment ne jamais dégrader volontairement leurs modèles, et rien ne prouve le contraire.
Sources
- Anthropic, A postmortem of three recent issues, 17 septembre 2025 (ouvre anthropic.com dans un nouvel onglet)
- TechCrunch, Anthropic unveils new rate limits for Claude Code, 28 juillet 2025 (ouvre techcrunch.com dans un nouvel onglet)
- GitHub anthropics/claude-code#42796, Stella Laurenzo, 2 avril 2026 (ouvre github.com dans un nouvel onglet)
- Boris Cherny, réponse du 6 avril 2026 (ouvre github.com dans un nouvel onglet)
- Anthropic, postmortem du 23 avril 2026 (ouvre anthropic.com dans un nouvel onglet)
- Anthropic, Redeploying Fable 5, 30 juin 2026 (ouvre anthropic.com dans un nouvel onglet)
- BridgeMind, « FABLE 5 CAME BACK NERFED », 2 juillet 2026 (ouvre x.com dans un nouvel onglet)
- @ClaudeDevs, 18 août 2026 (ouvre x.com dans un nouvel onglet)
- @ClaudeDevs, 29 août 2026, hausse permanente de 25 % (ouvre x.com dans un nouvel onglet)
- @ClaudeDevs, 29 août 2026, « 17% reduction » (ouvre x.com dans un nouvel onglet)
- Claude Code, CHANGELOG (2.1.260, cache Fable 5.1) (ouvre github.com dans un nouvel onglet)
- GitHub anthropics/claude-code#92201, 4 septembre 2026 (ouvre github.com dans un nouvel onglet)
- Business Insider, OpenAI Codex usage limit war room, 30 juin 2026 (ouvre businessinsider.com dans un nouvel onglet)
- Thibault Sottiaux, 29 juillet 2026, Sol et limites (ouvre x.com dans un nouvel onglet)
- Thibault Sottiaux, 22 août 2026, cache (ouvre x.com dans un nouvel onglet)
- Thibault Sottiaux, 29 août 2026, bugs de surconsommation (ouvre x.com dans un nouvel onglet)
- Thibault Sottiaux, 12 septembre 2026, qualité Astra (ouvre x.com dans un nouvel onglet)
- GitHub openai/codex#41220 (ouvre github.com dans un nouvel onglet)
- synthwavedd, 10 septembre 2026 (ouvre x.com dans un nouvel onglet)
- Dax Raad (@thdxr), 11 septembre 2026 (ouvre x.com dans un nouvel onglet)
- Antikythera_0, 11 septembre 2026 (ouvre x.com dans un nouvel onglet)
- Hacker News : jwr (ouvre news.ycombinator.com dans un nouvel onglet), big_toast (ouvre news.ycombinator.com dans un nouvel onglet), xingped (ouvre news.ycombinator.com dans un nouvel onglet)
- Trackers : Marginlab (ouvre marginlab.ai dans un nouvel onglet), livenerf (ouvre github.com dans un nouvel onglet), IsItNerfed (ouvre isitnerfed.org dans un nouvel onglet), Codex Quota Observatory (ouvre codex-quota.manetli.com dans un nouvel onglet)
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.
À lire aussi
- Claude Opus 5.5 écrase GPT-6 Astra et Codex, à une conditionOpus 5.5 fait 58 sur l’Intelligence Index d’Artificial Analysis, Astra 53, Sol 48. En agent de code : 66,0 contre 61,6 et 56,7. En tokens, c’est l’effort qui décide : au maximum Opus est le plus gourmand, en « high » il bat Astra au maximum en score, en coût et en tokens.
- Les resets d’OpenAI sont des cadeaux empoisonnés55 resets de quotas Codex recensés depuis septembre 2025, un tous les 6,9 jours. Ils réparent des bugs sans les chiffrer, décalent la semaine de l’abonné, servent d’argument de vente et ancrent une consommation que le forfait ne garantit pas. Ce qu’en dit la communauté.
- ChatGPT Pro Max à 500 $ : le « x50 » d’OpenAI n’est encore qu’une fuiteLe plan « promax » est apparu dans le code de ChatGPT et dans un commit public de Codex le 25 septembre 2026. Une capture l’affiche à 500 $ hors taxes, « Fastest Work and Codex ». Le 50× n’est qu’un calcul de blog. Annonce possible au DevDay du 29.