News · Logiciel
Agents API : le harnais Codex, facturé au token
Le 10 septembre 2026, OpenAI ouvre l’Agents API en beta. C’est le harnais Codex, en API. Pas de frais séparés : tokens, outils, et 0,03–1,92 $ / 20 min de sandbox. Résidence US only, pas de ZDR.
Le 10 septembre 2026, OpenAI a ouvert l’Agents API (ouvre developers.openai.com dans un nouvel onglet) en beta publique. Ce n’est pas un nouveau modèle. C’est le harnais qui fait tourner Codex, exposé en API. L’application envoie une tâche. OpenAI orchestre la session, compacte le contexte, reprend après un crash. Le compute, lui, peut rester chez OpenAI, chez un partenaire, ou chez vous.
Le blog le dit en une phrase : pas de frais séparés pour l’API. On paie les tokens, les outils, et le sandbox s’il est hébergé chez eux. C’est l’inverse du forfait Codex 20× : ici, le compteur a une unité.
Info
Contrôle du 20 septembre 2026. Annonce : Introducing the Agents API (ouvre openai.com dans un nouvel onglet), 10 septembre. Docs : overview (ouvre developers.openai.com dans un nouvel onglet), quickstart (ouvre developers.openai.com dans un nouvel onglet), configuration (ouvre developers.openai.com dans un nouvel onglet). Prix : API Pricing (ouvre developers.openai.com dans un nouvel onglet) (conteneurs). Résidence et ZDR : overview (ouvre developers.openai.com dans un nouvel onglet), Your data (ouvre developers.openai.com dans un nouvel onglet). Harnais open source : github.com/openai/codex (ouvre github.com dans un nouvel onglet). Vidéo officielle : YouTube, 10 septembre (ouvre youtube.com dans un nouvel onglet). Les chiffres clients sont ceux du blog OpenAI, pas un audit Yatofix.
Quatre objets, un harnais
La doc pose quatre concepts.
| Objet | Rôle |
|---|---|
| Agent | Modèle, instructions, outils, serveurs MCP |
| Environment | Sandbox optionnel : fichiers, skills, commandes |
| Session | Instance durable qui travaille et reprend |
| Events / items | Ce qu’on envoie, ce que la session produit |
Le parcours d’une session OpenAI-hosted : on crée la session, OpenAI provisionne l’environnement, on donne une tâche, on suit le flux ou un webhook, on continue ou on recale. Le harnais gère les commandes dans le sandbox, les skills, MCP, le steering, la compaction, les sous-agents, et la reprise.
Les clés d’application demandent api.agents.read et api.agents.write pour les sessions, plus api.responses.write pour l’inférence. Les requêtes portent OpenAI-Beta: agents=v1. Les SDK l’ajoutent. En cURL, il faut le coller.
Le modèle des exemples officiels, le 20 septembre, reste gpt-6-astra.
Un appel, pas un runtime à soi
L’exemple JavaScript du blog crée une session, branche un MCP, autorise trois sous-agents, et pose le travail dans /workspace/outputs :
const session = await client.beta.agents.sessions.create({
  agent: {
    model: "gpt-6-astra",
    tools: [{
      type: "mcp",
      server_label: "observability",
      transport: {
        type: "http",
        server_url: "https://observability.example.com/mcp",
      },
    }],
    multi_agent: { enabled: true, max_concurrent_subagents: 3 },
  },
  environment: {
    type: "openai_hosted",
    capability_directories: ["/workspace/capabilities/skills"],
  },
  input: "Investigate service-api’s elevated 5xx rate over the last 30 minutes.",
});
OpenAI héberge le harnais. L’application choisit le compute : sandbox OpenAI, infra maison, ou partenaire. On peut aussi sauver un agent avec client.beta.agents.create et le réutiliser via agent_id.
Le harnais, dit le blog, s’améliore avec les modèles. Trois morceaux déjà nommés :
- Compaction : quand la session approche la limite de contexte, l’API résume toute seule. Pas de logique maison.
- Tool search + programmatic tool calling : les définitions d’outils se chargent à la demande ; les appels peuvent tourner en parallèle et filtrer en code, pour ne ramener que le utile.
- Sous-agents :
multi_agent.enabled, chaque sous-agent a son contexte, l’agent principal rassemble.
MCP, fonctions custom, web search : la doc les accepte. Un MCP HTTP avec connection_origin: "service" tourne depuis OpenAI, sans sandbox. Un MCP stdio ou « environment » a besoin d’un environnement.
Trois environnements
environment.type | Qui tourne le compute |
|---|---|
none | Pas de sandbox. Questions, outils distants. |
openai_hosted | OpenAI provisionne le conteneur. |
self_hosted | Votre exécuteur se connecte à la session. |
Les partenaires listés le 10 septembre : Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop, Vercel. VPC, fichiers, CPU/GPU, cold start : c’est leur fiche, pas un tarif OpenAI unique.
Self-hosted ne change pas la résidence des données de l’API. La doc le dit deux fois.
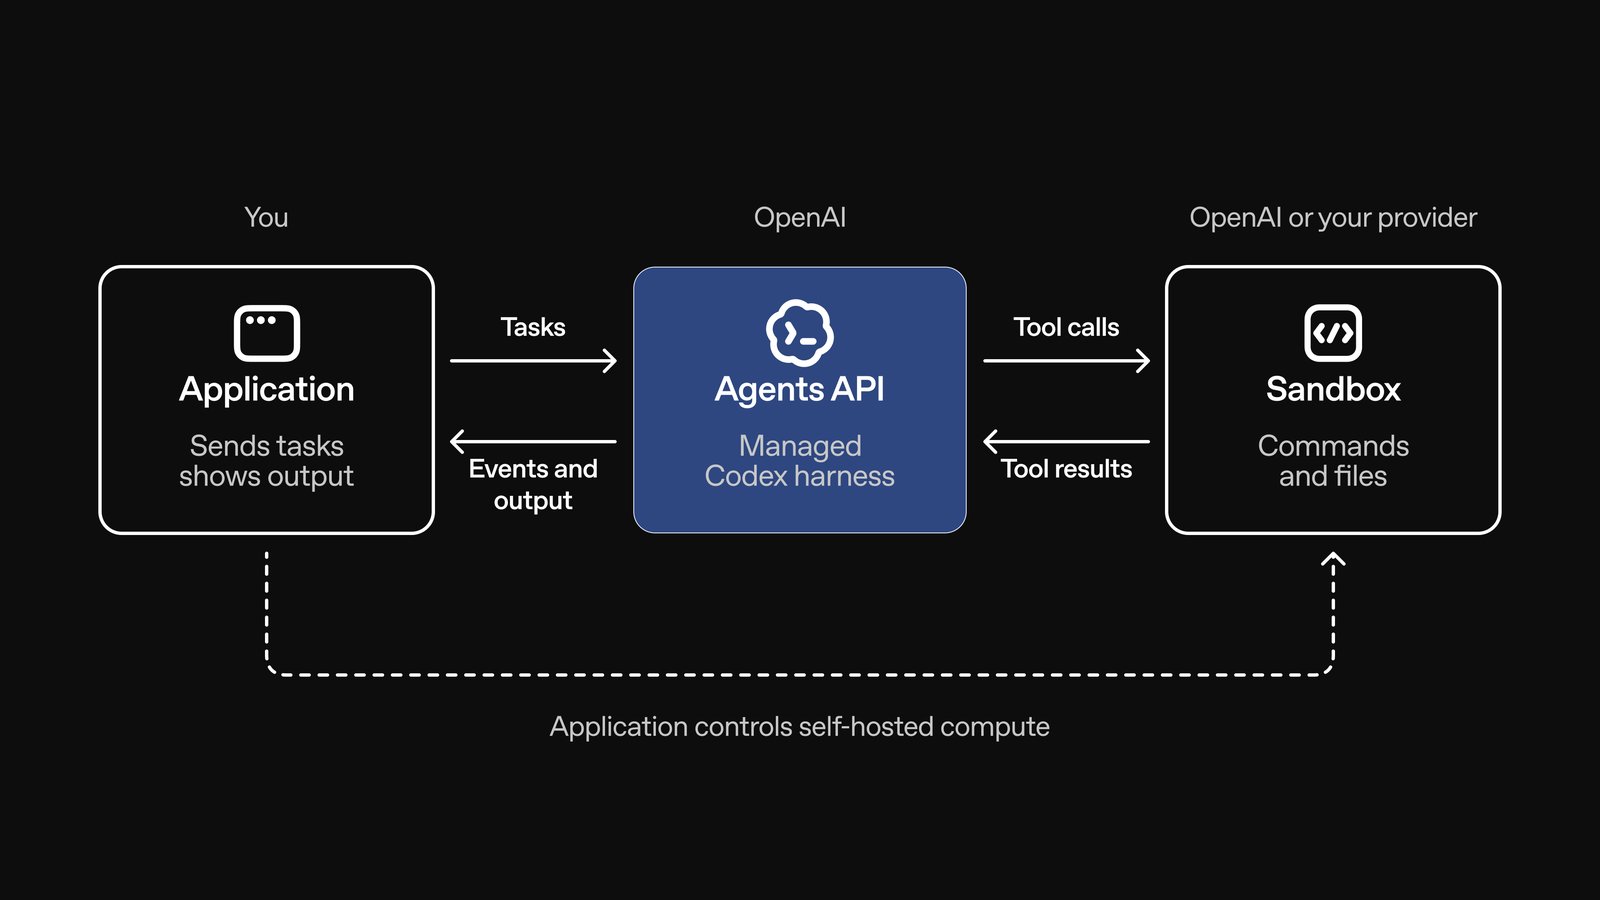
Crédit : OpenAI, schéma de l’annonce (ouvre openai.com dans un nouvel onglet). Le pointillé du bas : l’application contrôle le compute self-hosted.
Ce que ça coûte, ce que ça n’est pas
« There are no additional fees for using the Agents API », écrit OpenAI. On paie :
- Les tokens du modèle choisi, grille API (ouvre developers.openai.com dans un nouvel onglet).
- Les outils OpenAI à leurs tarifs (web search, etc.).
- Les conteneurs si le sandbox est
openai_hosted.
Grille conteneurs, relue le 20 septembre, Hosted Shell et Code Interpreter :
| Mémoire | Prix / session de 20 min |
|---|---|
| 1 GB | 0,03 $ |
| 4 GB | 0,12 $ |
| 16 GB | 0,48 $ |
| 64 GB | 1,92 $ |
Les sessions éligibles sont facturées à la minute, minimum 5 minutes. GB = Gio (2³⁰ octets).
Ce n’est pas un palier ChatGPT 20×. Pas de fourchette 100–900 messages. Un agent qui tourne des heures brûle des tokens Astra, plus le pot de sandbox. C’est lisible. Ça peut être cher.
Limite posée dans l’overview : l’Agents API ne fait de la résidence de données qu’aux États-Unis. Pas de Zero Data Retention. Un sandbox self-hosted ne rend pas l’API éligible au ZDR. Pour un projet EU ou un contrat ZDR, ce n’est pas le produit.
Crédit : OpenAI, visuel partenaires de l’annonce (ouvre openai.com dans un nouvel onglet), 10 septembre 2026. Modal, Cloudflare, Daytona, Blaxel, Runloop, Vercel, Oracle, E2B, DigitalOcean.
Ce que les clients cités racontent
Le blog aligne des citations. Ce sont des chiffres constructeur, attribués.
- Ciridae (Jack Weissenberger, CTO) : score d’éval 0,71 → 0,85, latence ÷4 grâce aux sous-agents.
- SafetyKit (Bhavyansh Sabharwal) : −60 % du coût par dossier après migration du workflow de revue.
- Hypha (Serhii Shchoholiev) : −86 % de réponses agent en échec, en séparant harnais et sandbox.
- Nash.ai (Aziz Alghunaim, CTO) : des milliers d’agents logistiques, sessions durables, reprise, workflows sur des heures ou des jours.
Long Lake, WithCoverage, Dwelly, deepsense.ai : le harnais, pas un benchmark public. On les laisse au blog.
Codex en forfait, Codex en API
L’Agents API n’annule pas le compteur Codex. Elle le contourne. Le 20× vend une fourchette. L’API vend des tokens et, si besoin, 0,03 $ les vingt minutes d’un conteneur 1 GB. Le harnais est le même dépôt openai/codex (ouvre github.com dans un nouvel onglet). La facture, non.
Beta : OpenAI dit qu’il itérera jusqu’à la GA. Pas de date. Les permissions, le header agents=v1 et la résidence US tiennent au 20 septembre.
Attention
Trois choses distinctes. (1) L’Agents API est le harnais Codex, pas un modèle. (2) Pas de frais d’API séparés, mais tokens + outils + conteneur. (3) Résidence US only, pas de ZDR, y compris en self-hosted. Les 0,71→0,85 de Ciridae et le −60 % de SafetyKit sont des citations du blog OpenAI, pas une moyenne du marché.
Sources
- OpenAI, Introducing the Agents API, 10 septembre 2026 (ouvre openai.com dans un nouvel onglet)
- OpenAI, Agents API overview (ouvre developers.openai.com dans un nouvel onglet)
- OpenAI, Agents API quickstart (ouvre developers.openai.com dans un nouvel onglet)
- OpenAI, Configuring Agents (ouvre developers.openai.com dans un nouvel onglet)
- OpenAI, Agents overview (API vs SDK vs Responses) (ouvre developers.openai.com dans un nouvel onglet)
- OpenAI, API Pricing — containers (ouvre developers.openai.com dans un nouvel onglet)
- OpenAI, Your data (ouvre developers.openai.com dans un nouvel onglet)
- GitHub openai/codex (ouvre github.com dans un nouvel onglet)
- OpenAI, Introducing the Agents API, YouTube (ouvre youtube.com dans un nouvel onglet)
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.
À lire aussi
- MLX : les gros modèles tiennent enfin sur un MacLe 20 septembre 2026, MLX fait tourner en local ce qu’on envoyait au cloud. WWDC : cluster Thunderbolt, Kimi 2.6 à 1 T. Rapid-MLX : V4.1-Flash 2-bit sur un M3 Ultra 256 Go, 7,3 tok/s. Pas un MacBook 16 Go.
- RX 9050 4 Go : même nom, bus 64-bit, OEM onlyLe 19–20 septembre 2026, Hardware Unboxed et Clubic mesurent la RX 9050 4 Go OEM. Même GPU que la 8 Go, bus 64-bit, 144 Go/s. En 1080p Low, la 8 Go est 37 % plus vite. Pas au rayon.
- GLM Coding Plan : 18, 80 et 168 $, en créditsAu 20 septembre 2026, GLM Coding Plan : Lite 18 $, Pro 80 $, Max 168 $. Crédits 5 h + semaine, hors-pointe à 50 %. Pas une API générale. Campagne Flash jusqu’au 20.