News · Logiciel
MLX : les gros modèles tiennent enfin sur un Mac
Le 20 septembre 2026, MLX fait tourner en local ce qu’on envoyait au cloud. WWDC : cluster Thunderbolt, Kimi 2.6 à 1 T. Rapid-MLX : V4.1-Flash 2-bit sur un M3 Ultra 256 Go, 7,3 tok/s. Pas un MacBook 16 Go.
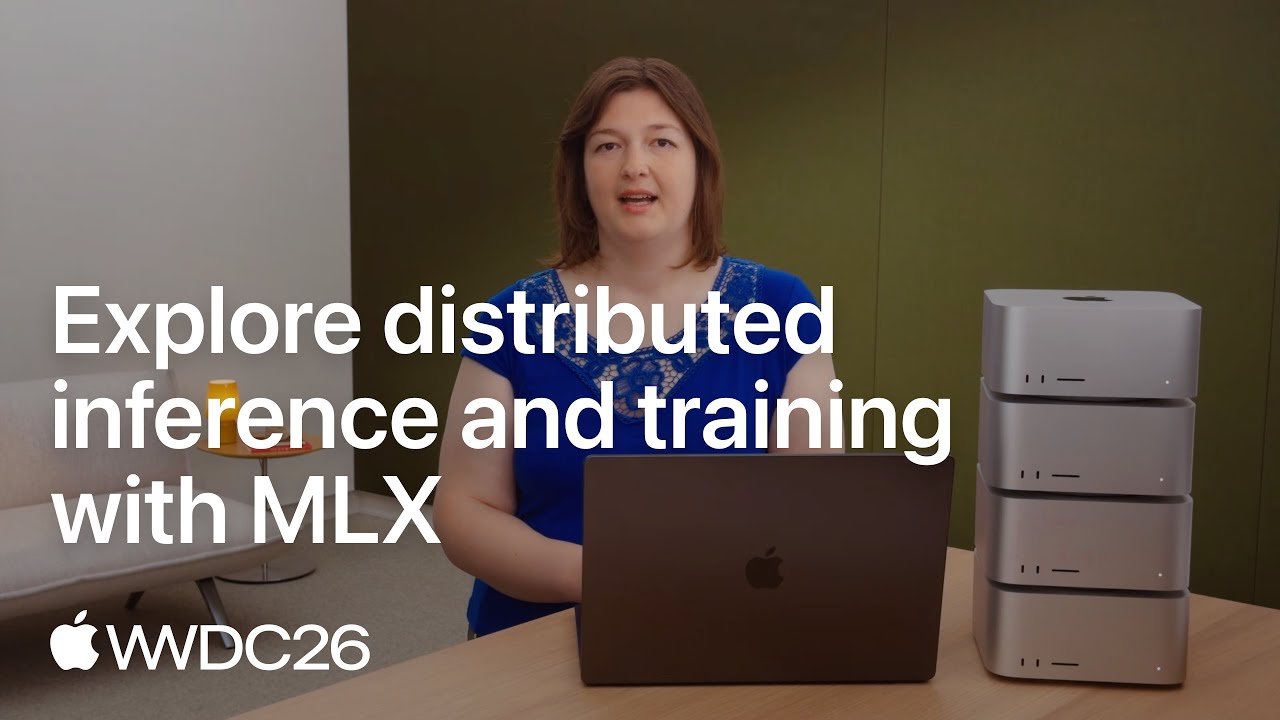
Le 20 septembre 2026, un Mac n’est plus seulement une machine à 7 B. MLX, le framework open source d’Apple pour Apple silicon, fait tourner des MoE à cent milliards de paramètres, et, en cluster Thunderbolt, des modèles à 1 000 milliards. Rapid-MLX vient de poser DeepSeek V4.1-Flash en 2-bit sur un M3 Ultra 256 Go. Ce n’est pas magique. C’est de la mémoire unifiée, des quants, et encore beaucoup de Go.
Info
Contrôle du 20 septembre 2026. MLX : ml-explore/mlx (ouvre github.com dans un nouvel onglet) v0.32.2 (25 août), mlx-lm (ouvre github.com dans un nouvel onglet) pip 0.31.3 (22 avril). Docs : ml-explore.github.io/mlx (ouvre ml-explore.github.io dans un nouvel onglet). Apple : What’s new, ML (ouvre developer.apple.com dans un nouvel onglet), WWDC26 session 232 (ouvre developer.apple.com dans un nouvel onglet) et 233 (ouvre developer.apple.com dans un nouvel onglet). Poids : mlx-community (ouvre huggingface.co dans un nouvel onglet). V4.1 local : Rapid-MLX 0.14.1 (ouvre github.com dans un nouvel onglet), REAP 2-bit (ouvre huggingface.co dans un nouvel onglet), DSpark (ouvre huggingface.co dans un nouvel onglet). Le hardware Mac Studio M5 est déjà traité ici. Les tok/s Rapid-MLX sont des mesures constructeur, M3 Ultra 256 Go.
Ce que MLX change
MLX n’est pas Ollama. C’est un framework de tenseurs, sorti par Apple machine learning research fin 2023 : API proche de NumPy, CPU et GPU, mémoire unifiée. Les tableaux vivent dans le même pool que le reste du Mac. Pas de copie PCIe vers une VRAM séparée. Le README le dit en une phrase : « Operations on MLX arrays can be performed on any of the supported device types without transferring data. »
Au 20 septembre : 28 489 étoiles sur ml-explore/mlx (ouvre github.com dans un nouvel onglet), dernière release v0.32.2 le 25 août. mlx-lm (ouvre github.com dans un nouvel onglet) (7 075 étoiles) charge, quantifie, fine-tune et sert des LLM. pip install mlx-lm installe encore 0.31.3 (22 avril). Le dépôt GitHub, lui, pousse encore le 20 septembre. Ce n’est pas la même binaire.
Les poids sont sur mlx-community (ouvre huggingface.co dans un nouvel onglet). Un serveur local :
pip install mlx-lm
mlx_lm.server --model mlx-community/Qwen-3.5-4B-8bit
WWDC26, session 232 : on pointe OpenCode (ou n’importe quel client OpenAI-compat) sur http://127.0.0.1:8080/v1. L’agent tourne chez soi. Pas de clé cloud.
Un Mac, puis quatre
Un seul Mac sature. Apple le dit : DeepSeek « most recent » à 1,6 T de paramètres, plus de 800 Go rien que pour les poids. Kimi 2.6 : 1 T, même en 8-bit les poids tiennent environ 1 To.
La session 233 montre le contournement : mlx.launch, un hostfile, Thunderbolt ou Ethernet. À partir de macOS 26.2, RDMA over Thunderbolt. Apple : jusqu’à ×3 avec quatre nœuds. Exemple officiel, Qwen 3.6 27 B sur un M3 Ultra vs quatre. Exemple serveur, un 122 B MoE 8-bit :
mlx.launch --hostfile hosts.json --backend jaccl \
  /remote/path/to/mlx_lm.server \
  --model mlx-community/Qwen-3.5-122B-A3B-8bit
Pour Kimi 2.6, Apple ajoute --pipeline : parallélisme de pipeline, pas seulement de tenseur. Ce n’est plus « un LLM dans le terminal ». C’est un rack de Mac Studio sur le bureau. La page What’s new (ouvre developer.apple.com dans un nouvel onglet) ajoute Metal 4 et les Neural Accelerators des M5 Pro / Max. Le Mac Studio M5 donne les Go. MLX donne le logiciel.
Crédit : Hugging Face, visuel Open Graph de mlx-community (ouvre huggingface.co dans un nouvel onglet), 20 septembre 2026.
V4.1-Flash en local : 256 Go, et encore expérimental
Le 11 septembre, Rapid-MLX 0.14.1 annonce DeepSeek V4.1-Flash sur Apple silicon. Le checkpoint REAP 2-bit (ouvre huggingface.co dans un nouvel onglet) est clair : artefact de recherche, pas un modèle « product-qualified ». Loader Rapid-MLX 0.14.1 seulement. Pas mlx-lm pip. Pas de vision. Pas de MTP. 256 GiB unifiés minimum.
Mesure Rapid-MLX, M3 Ultra 60 GPU, 256 Go, MLX 0.32.2 :
| Résultat | |
|---|---|
| Payload tenseurs | 212,93 Go (~199 GiB) |
| Pic mémoire MLX | 213,51 Go |
| Decode conservateur | 7,31 tok/s |
| Plafond court | 7,92 tok/s |
| Experts gardés | 336 / 384 par couche |
Le dépôt dit que ça rate le plancher produit Rapid-MLX de 12 tok/s de 34 %. Un smoke test : « The capital of France is Paris. » Tool use et long contexte : non évalués. Le 2-bit et le pruning peuvent casser la qualité. Ce n’est pas l’API deepseek-flash à 0,15 $.
Le sidecar DSpark 4d2e (ouvre huggingface.co dans un nouvel onglet), même machine : 9,58 tok/s en autorégressif, 19,39 tok/s en DSpark K=4 (×2,02). Pic 218,2 Go. Rapid-MLX : instruction-following « weak or repetitive » sur plusieurs probes anglais. Expérimental.
mlx-lm officiel, PyPI 0.31.3, n’a pas deepseek_v41. Un PR « Add DeepSeek-V4.1 model » est ouvert le 16 septembre sur GitHub. On ne le dit pas mergé.
Crédit : Hugging Face, visuel Open Graph de rapid-mlx/DeepSeek-V4.1-Flash-REAP-2bit-MLX (ouvre huggingface.co dans un nouvel onglet), 11 septembre 2026.
Ce qui tient, selon les Go
Ce n’est pas « n’importe quel Mac ». Ordre de grandeur, pas un banc Yatofix :
| Mémoire unifiée | Ce qui est raisonnable |
|---|---|
| 16 Go | 7–9 B 4-bit. Pas V4.1. |
| 32–64 Go | 27–35 B, surtout MoE 4-bit. |
| 128 Go | 122 B MoE 8-bit (exemple WWDC), ou un dense 70 B quantifié. |
| 256 Go | V4.1-Flash 2-bit REAP, expérimental, ~7 tok/s. |
| 512 Go | Quants plus larges, ou un nœud de cluster. |
| Plusieurs Mac, Thunderbolt RDMA | 1 T (Kimi 2.6), 1,6 T (DeepSeek), si ça tient en 8-bit sharded. |
Un MacBook Air 16 Go fait du local utile. Il ne fait pas « le gros modèle ». Les gros modèles, en septembre 2026, c’est un Studio bien rempli, ou une pile de quatre.
Attention
Trois choses. (1) MLX = mémoire unifiée + Metal, pas un chatbot. (2) Apple documente le cluster et les 1 T ; Rapid-MLX documente V4.1-Flash 2-bit à 7,3 tok/s sur 256 Go, expérimental. (3) pip install mlx-lm est encore 0.31.3. V4.1 n’y est pas.
Sources
- GitHub ml-explore/mlx (ouvre github.com dans un nouvel onglet)
- GitHub ml-explore/mlx-lm (ouvre github.com dans un nouvel onglet)
- MLX documentation (ouvre ml-explore.github.io dans un nouvel onglet)
- Apple Developer, What’s new — MLX (ouvre developer.apple.com dans un nouvel onglet)
- WWDC26, Run local agentic AI on the Mac using MLX (ouvre developer.apple.com dans un nouvel onglet)
- WWDC26, Explore distributed inference and training with MLX (ouvre developer.apple.com dans un nouvel onglet)
- Hugging Face, mlx-community (ouvre huggingface.co dans un nouvel onglet)
- Rapid-MLX 0.14.1 (ouvre github.com dans un nouvel onglet)
- Hugging Face, DeepSeek-V4.1-Flash-REAP-2bit-MLX (ouvre huggingface.co dans un nouvel onglet)
- Hugging Face, DeepSeek-V4.1-Flash-DSpark-4d2e-MLX (ouvre huggingface.co dans un nouvel onglet)
- PyPI, mlx 0.32.2 (ouvre pypi.org dans un nouvel onglet)
- PyPI, mlx-lm 0.31.3 (ouvre pypi.org dans un nouvel onglet)
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.
À lire aussi
- RX 9050 4 Go : même nom, bus 64-bit, OEM onlyLe 19–20 septembre 2026, Hardware Unboxed et Clubic mesurent la RX 9050 4 Go OEM. Même GPU que la 8 Go, bus 64-bit, 144 Go/s. En 1080p Low, la 8 Go est 37 % plus vite. Pas au rayon.
- GLM Coding Plan : 18, 80 et 168 $, en créditsAu 20 septembre 2026, GLM Coding Plan : Lite 18 $, Pro 80 $, Max 168 $. Crédits 5 h + semaine, hors-pointe à 50 %. Pas une API générale. Campagne Flash jusqu’au 20.
- DeepSeek V4.1-Flash : 0,15 $ / 0,60 $ hors pointeLe 10 septembre 2026, DeepSeek lance V4.1-Flash : MoE 552 B, 8 B actifs en entrée, vision native. API deepseek-flash à 0,15 $ / 0,60 $ hors pointe. V4-Pro reste listé le 20. Chiffres constructeur.