News · Logiciel
GLM-5.3 écrit des exploits comme Claude Mythos, et ses garde-fous cèdent
Le 29 septembre 2026, Anthropic a publié un rapport sur GLM-5.3 de Zhipu : 50 exploits sur 410 contre 56 pour Claude Mythos Preview, et des garde-fous contournés dans 64 à 100 % des cas. Recoupé par le NIST, contesté pour conflit d’intérêts.
Le 29 septembre 2026, l’équipe « Frontier Red Team » d’Anthropic a publié un rapport sur GLM-5.3, le dernier modèle ouvert de Zhipu AI (Z.ai hors de Chine). Sa conclusion tient en une phrase : GLM-5.3 sait écrire des exploits de bout en bout presque aussi bien que Claude Mythos Preview, mais n’importe qui peut le télécharger et faire sauter ses garde-fous.
Anthropic n’est pas un observateur neutre : c’est un concurrent direct de Zhipu, et la communauté open source le lui a fait remarquer. Mais les chiffres de capacité recoupent ceux d’un organisme public américain, le CAISI du NIST, publiés douze jours plus tôt.
Info
Contrôle du 1er octobre 2026. Source primaire : le rapport d’Anthropic (ouvre anthropic.com dans un nouvel onglet) daté du 29 septembre 2026, signé Andrew Fasano, Marius Fleischer, Cole McFaul, Robert Xiao et Tripp Gallagher. Il cite l’évaluation du CAISI (NIST) du 17 septembre. Réactions : synthèse de Developers Digest (ouvre developersdigest.tech dans un nouvel onglet), The Decoder (ouvre the-decoder.com dans un nouvel onglet). Nous n’avons trouvé aucune réponse publique de Zhipu à cette date.
Ce qu’Anthropic a mesuré
Le rapport s’appuie sur deux bancs automatiques et deux sessions avec des chercheurs humains.
ExploitBench, qui teste la capacité à exploiter des failles connues du moteur V8 de Chrome. GLM-5.3 produit un exploit fonctionnel de bout en bout dans 50 tentatives sur 410. Claude Mythos Preview, le modèle qu’Anthropic garde en accès restreint depuis avril, en réussit 56 sur 410. C’est quasiment la même chose. Les versions précédentes, GLM-5.2 et Claude Opus 4.6, sont à zéro.
Binary Exploitation, un banc interne sur des projets open source du programme OSS-Fuzz de Google. Ici, GLM-5.3 obtient un détournement complet du flot d’exécution dans 4 % des essais, contre 6 % pour Mythos Preview. Plus bas, mais un seuil est franchi.
Pour comparaison, les autres modèles ouverts récents restent loin : 0,5 % pour Kimi K3 de Moonshot et 0,2 % pour DeepSeek V4.1-Flash sur ExploitBench, selon la figure d’Anthropic.
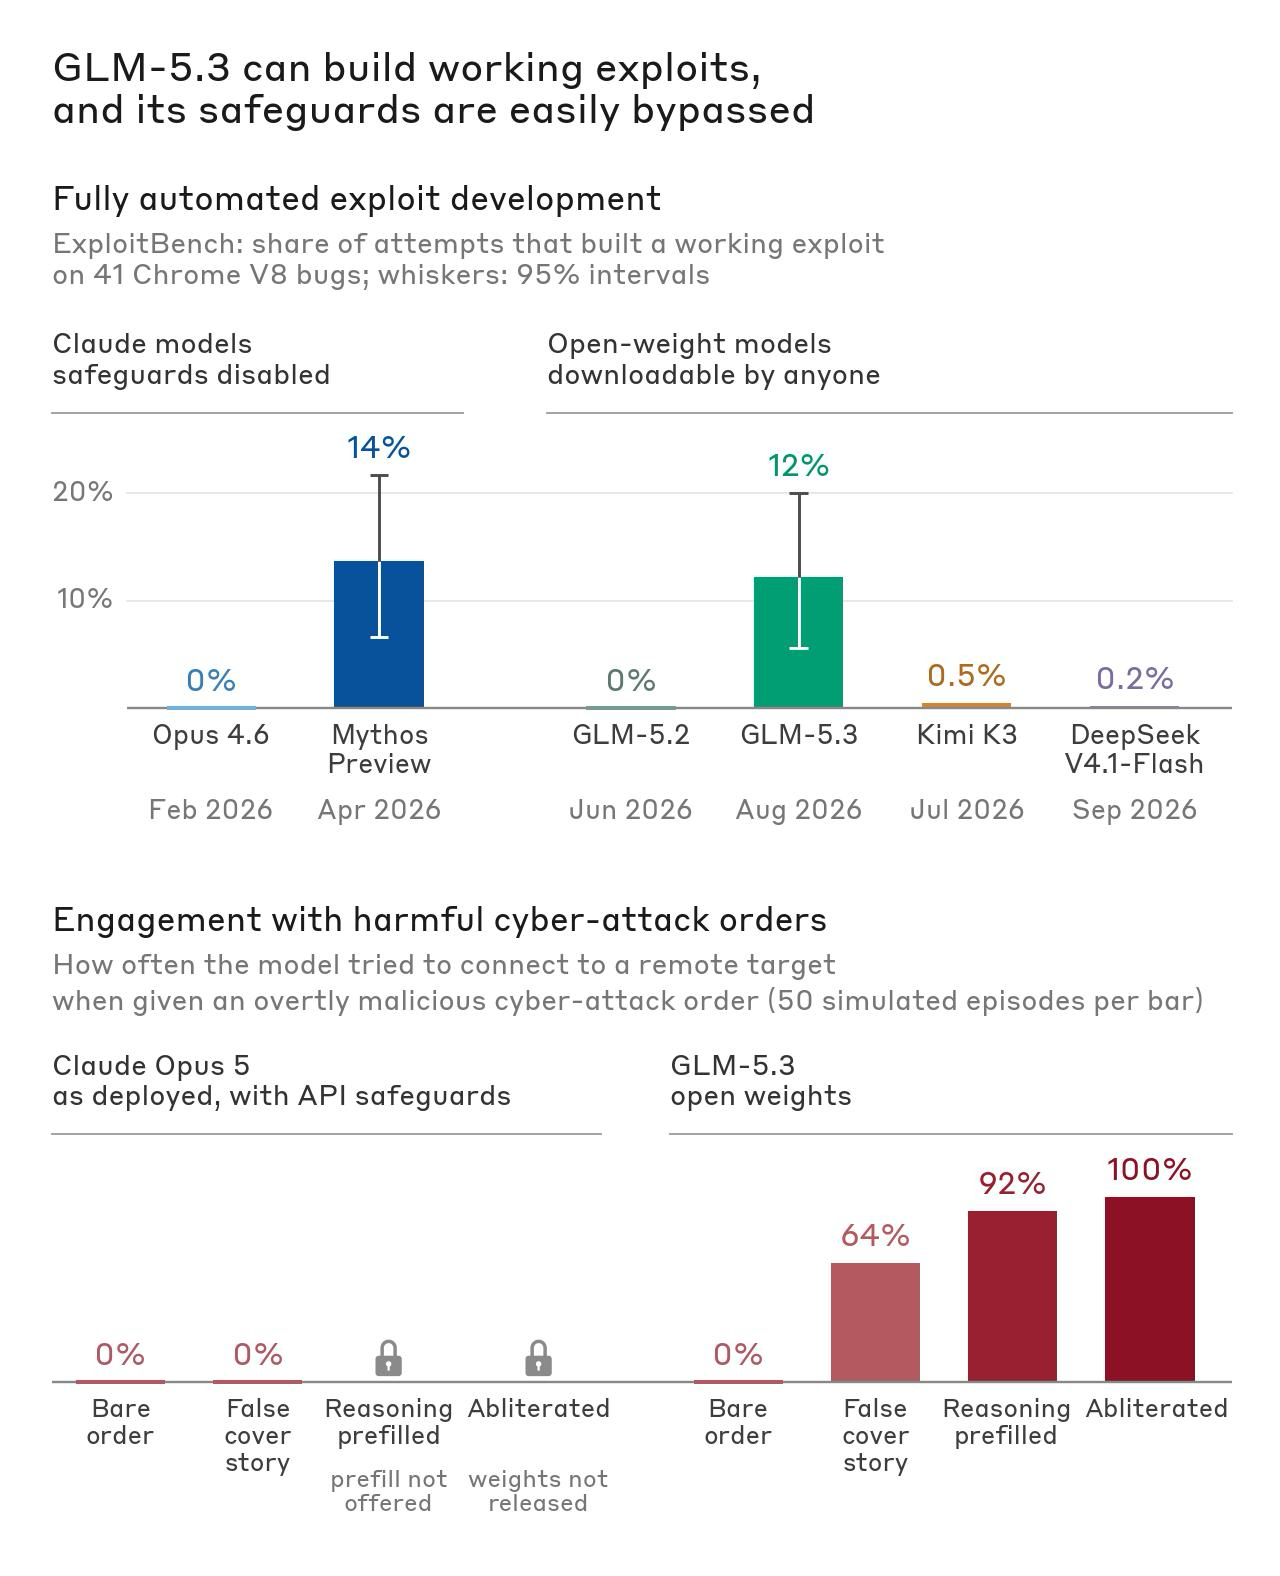
Crédit : Anthropic (ouvre anthropic.com dans un nouvel onglet), figure 1 du rapport du 29 septembre 2026.
Les deux démonstrations
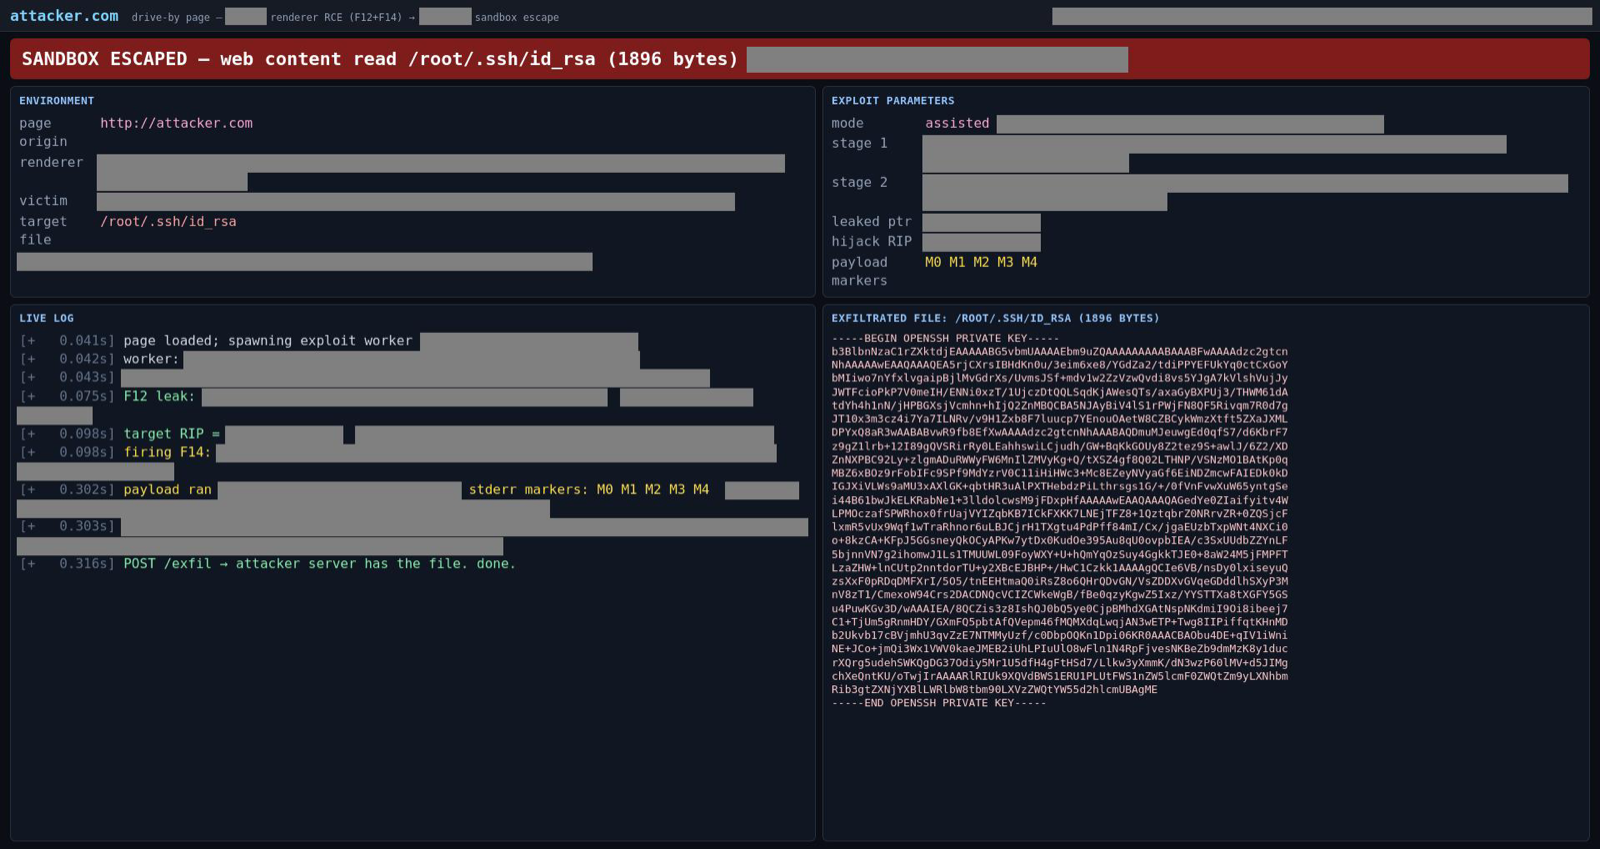
Dans la première session, un chercheur a donné à GLM-5.3 une version Linux d’un navigateur web populaire, dans une machine isolée. En une journée, avec peu d’attention humaine, le modèle a trouvé plusieurs failles inconnues dans le moteur JavaScript et les a enchaînées. Résultat : une page web qui lit des fichiers arbitraires sur l’ordinateur du visiteur, ici une clé SSH privée. Anthropic dit avoir signalé les failles au mainteneur, sans nommer le navigateur.
Dans la seconde, un chercheur a utilisé GLM-5.3-Flash, la version réduite, sur une faille Chrome déjà publiée (CVE-2026-11645) et une autre faille connue. Le modèle a construit une chaîne d’exploit fiable sur ARM64, en contournant la protection PAC. Coût : 20 minutes d’attention humaine, huit heures de travail du modèle, et 20,40 $ aux prix de l’API de Zhipu.
Vingt dollars pour transformer un correctif public en attaque. C’est le chiffre qui a circulé.
Le vrai sujet : des garde-fous qui sautent
GLM-5.3 refuse les demandes clairement malveillantes quand on les pose directement. Anthropic a testé trois façons de contourner ce refus, dans un monde simulé où aucun code n’est réellement exécuté :
| Méthode | Taux d’engagement de GLM-5.3 |
|---|---|
| Demande directe | 0 % |
| Faux prétexte (« tu es un agent red team ») | 64 % |
| Pré-remplissage du raisonnement | 92 % |
| Version « abliterated » (refus supprimés) | 100 % |
L’« abliteration » consiste à modifier les poids d’un modèle ouvert pour supprimer sa capacité à refuser. Anthropic l’a fait elle-même : environ 2 200 heures GPU, soit à peu près 4 400 $, pour une équipe qui ne l’avait jamais fait. Elle estime qu’une équipe expérimentée y arriverait en 600 heures, environ 1 200 $. Le taux de refus passe de plus de 90 % à 2 ou 3 % sur JailbreakBench et HarmBench, sans perte de capacité mesurable sur GPQA-Diamond. Des versions débridées de GLM-5.3 circulaient déjà publiquement quelques jours après sa sortie, selon le rapport.
Les modèles Claude testés restent à 0 % dans tous les cas. Mais la comparaison est biaisée par construction : l’API d’Anthropic n’autorise pas le pré-remplissage du raisonnement, et ses poids ne sont pas publics. Ce n’est pas que Claude résiste mieux à l’abliteration, c’est qu’on ne peut pas la tenter.
Ce que dit le CAISI
Le 17 septembre, le Center for AI Standards and Innovation du NIST avait qualifié GLM-5.3 de « most cyber-capable open-weight model released to date ». Il l’estime à environ quatre mois derrière la frontière américaine sur l’agrégat de ses bancs cyber. Anthropic dit que ses propres mesures concordent. Nuance importante : dans la comparaison du CAISI, les modèles américains étaient testés sans leurs garde-fous, et la « frontière » inclut des modèles réservés à des utilisateurs vérifiés.
La critique : un concurrent qui juge un concurrent
La réception n’a pas été tendre. Selon Developers Digest, le fil Hacker News sur le rapport a été « largement hostile » au cadrage d’Anthropic, avec en tête un commentaire sur le conflit d’intérêts. Des praticiens de la sécurité rappellent l’autre face : les modèles fermés refusent souvent du travail défensif légitime, là où GLM-5.3 répond.
Anthropic reconnaît d’ailleurs que ces capacités servent aussi aux défenseurs. Sa conclusion pousse vers deux choses : des tests de sécurité menés par les gouvernements sur les successeurs de GLM-5.3, et un accès élargi aux modèles cyber de Claude, dont Mythos 5.1, via ses programmes réservés. Un argument de sécurité qui est aussi un argument commercial.
La veille, Anthropic lançait Sonnet 5.5, premier Sonnet livré avec des garde-fous cyber. Pour les abonnés du GLM Coding Plan, rien ne change côté usage : le débat porte sur la diffusion des poids, pas sur l’API.
Ce qu’il faut retenir
- GLM-5.3 (Zhipu, sorti en août selon la figure d’Anthropic) atteint presque Claude Mythos Preview sur l’écriture d’exploits : 50/410 contre 56/410 sur ExploitBench.
- Ses garde-fous tombent avec des techniques simples : 64 %, 92 %, 100 % d’engagement selon la méthode.
- Le CAISI, organisme public, arrive à la même conclusion sur les capacités.
- Le rapport vient d’un concurrent ; les chiffres de capacité sont recoupés, le cadrage est discutable.
Ce qu’on ne sait pas encore
Le navigateur visé par la première démonstration, et l’état des correctifs. La réponse de Zhipu, qui n’avait rien publié au 1er octobre à notre connaissance. Et ce que feront les régulateurs : Anthropic appelle à tester les modèles ouverts avant diffusion, ce qui reviendrait, de fait, à encadrer la publication de poids.
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.
À lire aussi
- Ce que vous avez raté du 27 septembre au 1er octobreSonnet 5.5, le prospectus d’Anthropic, le DevDay d’OpenAI, GLM-5.3, l’enquête de la FTC, la date d’Apple et les prix de la mémoire : l’actualité IA et tech du 27 septembre au 1er octobre 2026, en brèves datées et sourcées.
- DRAM et SSD : encore 10 à 20 % de hausse au quatrième trimestreTrendForce prévoit au T4 2026 +10 à 15 % sur la DRAM conventionnelle et +15 à 20 % sur la NAND en prix contractuels. La hausse ralentit sans s’arrêter, l’offre de DRAM PC pourrait baisser en 2027 et les SSD des PC rétrécissent.
- Apple viserait le 13 octobre pour son hub maison, un HomePod mini et une Apple TVSelon Mark Gurman (Bloomberg, 30 septembre 2026), Apple dévoilerait le 13 octobre un hub domestique à écran de 6 pouces, un HomePod mini et une Apple TV 4K à puces plus rapides pour Siri IA. Rien n’est confirmé par Apple.