News · Logiciel
Claude Opus 5.5 écrase GPT-6 Astra et Codex, à une condition
Opus 5.5 fait 58 sur l’Intelligence Index d’Artificial Analysis, Astra 53, Sol 48. En agent de code : 66,0 contre 61,6 et 56,7. En tokens, c’est l’effort qui décide : au maximum Opus est le plus gourmand, en « high » il bat Astra au maximum en score, en coût et en tokens.
Cinq jours après sa sortie, Claude Opus 5.5 est le modèle le plus intelligent jamais mesuré par Artificial Analysis : 58 points sur son Intelligence Index, contre 53 pour GPT-6 Astra. Sur le banc d’agents de code du même laboratoire, Claude Code avec Opus 5.5 fait 66,0, Codex avec Astra 61,6, Codex avec GPT-6 Sol 56,7. Sur le terrain de l’intelligence, OpenAI n’a pas de réponse cette semaine.
Sur celui des tokens, le tableau est plus subtil. Poussé à l’effort maximal, Opus 5.5 est un gouffre : 4,4 fois plus de tokens de sortie qu’Astra par tâche. Mais un cran en dessous, à l’effort « high », il bat Astra poussé au maximum sur les trois tableaux à la fois : score, coût et tokens. C’est là que le « Opus écrase Astra » devient vrai. Pas partout, pas à n’importe quel réglage.
Info
Contrôle du 27 septembre 2026. Constructeur : annonce Anthropic (ouvre anthropic.com dans un nouvel onglet) et documentation (ouvre platform.claude.com dans un nouvel onglet), 22 septembre. Mesures indépendantes : Artificial Analysis (ouvre artificialanalysis.ai dans un nouvel onglet), pages modèles et Coding Agent Index (ouvre artificialanalysis.ai dans un nouvel onglet), chiffres relus dans les données publiées le 27. OpenAI : GPT-6 Sol et Luna (ouvre openai.com dans un nouvel onglet). Les benchmarks d’Anthropic sont des chiffres constructeur ; ceux d’Artificial Analysis sont mesurés par un tiers.
Ce qu’Anthropic a sorti le 22 septembre
Opus 5.5 est disponible depuis le 22 septembre sur l’API Claude, AWS, Google Cloud et Azure, et dans les abonnements Claude. Le prix baisse : 4 $ le million de tokens en entrée, 20 $ en sortie, contre 5 $ et 25 $ pour Opus 5. La lecture de cache passe de 0,50 $ à 0,20 $. Contexte d’un million de tokens, 128 000 en sortie.
Côté abonnés, Anthropic annonce une hausse des limites sur cinq heures pour Pro, Max, Team et Enterprise, et un reset de quota offert. Mixed News chiffre la hausse à 20 % et situe la fin du reset au 22 octobre ; Anthropic ne publie pas le pourcentage sur sa page.
Le même jour, OpenAI sortait GPT-6 Sol et Luna, et baissait de moitié leur prix API. Sol, désormais modèle par défaut de Codex, coûte 2 $ et 10 $ le million. Astra, sorti le 3 septembre, reste à 10 $ et 50 $.
L’intelligence : Opus devant presque partout
Le tableau publié par Anthropic, avec les chiffres d’OpenAI tels que rapportés par OpenAI :
| Banc | Opus 5.5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 | 54,4 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | — | 41,7 % |
| GDPval-AA v2.1 (Elo) | 1 846 | 1 542 | 1 588 |
| Humanity’s Last Exam | 67,7 % | 57,2 % | — |
| AutomationBench | 40,0 % | 41,4 % | 28,8 % |
| Terminal-Bench-Science | 58,7 % | 64,6 % | 22,4 % |
Deux réserves. Opus 5.5 est mesuré à l’effort maximal (xhigh sur Terminal-Bench), Astra à l’effort « high ». Et l’écart sur FrontierCode, 1,1 point, est dans le bruit. Astra garde deux bancs : l’automatisation et la science en terminal.
Artificial Analysis confirme la hiérarchie avec ses propres mesures. Opus 5.5 au maximum : 58, premier sur 211 modèles, « the highest score we have measured by several points ». Astra au maximum : 53. Sol au maximum : 48.
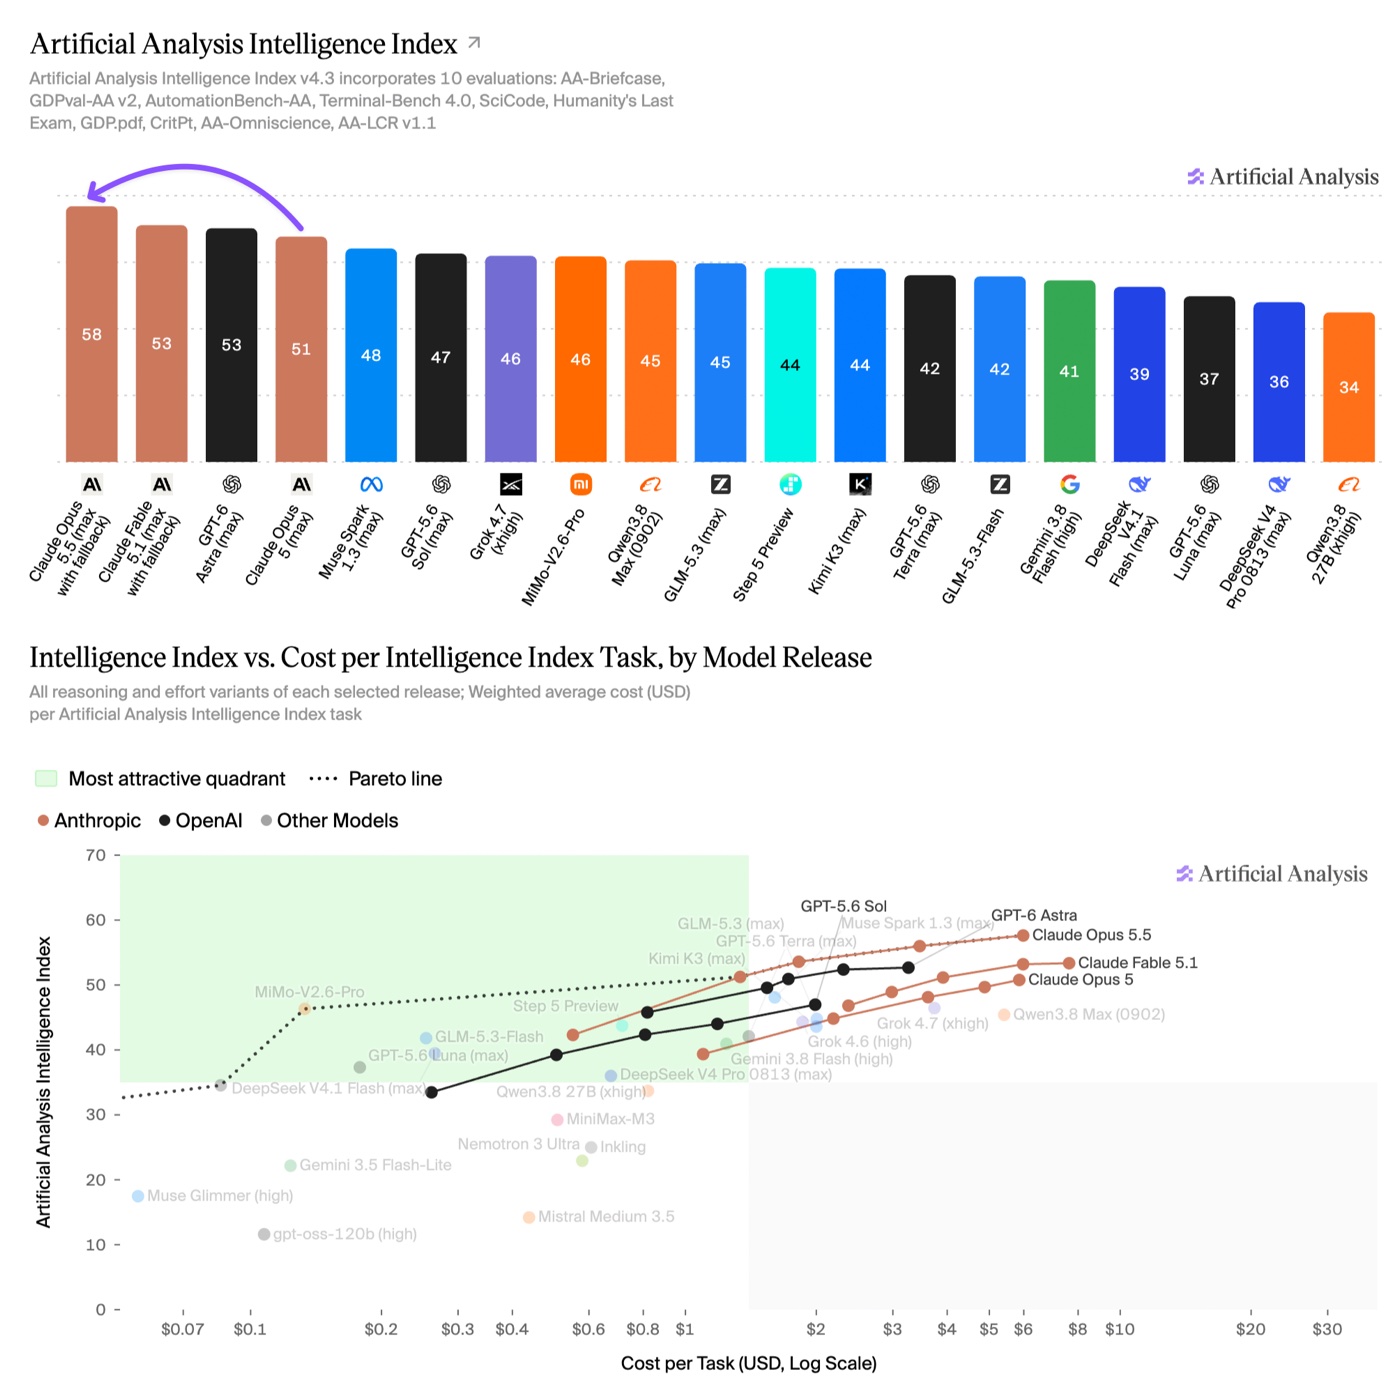
Crédit : Artificial Analysis (ouvre artificialanalysis.ai dans un nouvel onglet), 22 septembre 2026. Graphique redimensionné, non modifié.
Les tokens : le vrai match
C’est ici que les impressions de forum et les chiffres se séparent. Les pages modèles d’Artificial Analysis donnent, pour tout l’Intelligence Index :
| Modèle et effort | Score | Coût par tâche | Tokens générés |
|---|---|---|---|
| Opus 5.5, max | 58 | 5,98 $ | 260 M |
| Opus 5.5, high | 54 | 1,82 $ | 53 M |
| Opus 5.5, medium | 51 | 1,34 $ | 38 M |
| GPT-6 Astra, max | 53 | 3,26 $ | 60 M |
| GPT-6 Sol, max | 48 | 1,06 $ | 77 M |
Lu ligne par ligne :
- Au maximum, Opus 5.5 est le plus bavard du lot. Environ 119 000 tokens de sortie par tâche, contre 27 000 pour Astra. Artificial Analysis note aussi qu’il en produit 1,6 fois plus qu’Opus 5 au même réglage. Son coût par tâche ne tient que grâce à la baisse de prix.
- À « high », il écrase Astra au maximum. 54 contre 53 en score, 1,82 $ contre 3,26 $ par tâche, 53 millions de tokens contre 60. Plus intelligent, 44 % moins cher, et plus sobre. C’est le chiffre qui justifie le titre.
- À « medium », le réglage par défaut, il reste devant Sol au maximum (51 contre 48) pour 38 millions de tokens au lieu de 77. Anthropic affirme de son côté qu’au réglage par défaut, Opus 5.5 bat Astra au maximum sur GDPval-AA pour environ un cinquième du coût par tâche. C’est un chiffre constructeur.
En agent de code : meilleur, mais pas sobre
Le Coding Agent Index v1.5 d’Artificial Analysis fait tourner les agents eux-mêmes, Claude Code contre Codex, sur des tâches de développement longues. Chiffres relus dans les données de la page le 27 septembre :
| Agent | Score | Coût par tâche | Tokens de sortie par tâche | Étapes |
|---|---|---|---|---|
| Claude Code, Opus 5.5 max | 66,0 | 13,04 $ | 333 k | 155 |
| Codex, GPT-6 Astra max | 61,6 | 7,47 $ | 47 k | 39 |
| Codex, GPT-6 Sol max | 56,7 | 2,99 $ | 62 k | 86 |
Opus 5.5 est le meilleur agent de code mesuré, avec plus de quatre points d’avance sur Astra et neuf sur Sol. Mais il y arrive en 155 étapes, contre 39 pour Astra, et en produisant environ sept fois plus de tokens. Il coûte 1,75 fois plus par tâche. En agent, au réglage maximal, la victoire d’Opus est une victoire d’endurance, pas d’économie.
Face au modèle par défaut de Codex, Sol, l’écart d’intelligence est net partout : +10 points sur l’Intelligence Index au maximum, +9 points en agent de code. Face à Astra, tout dépend du réglage.
Ce qu’en disent les utilisateurs
Sur Hacker News, dans le fil de lancement, les deux camps se répondent. cbg0 : « I have a subscription to both and Astra burns usage like crazy ». notatoad : « Astra burned through 70% of my weekly usage in ~5hrs on a $100 plan ». drcongo décrit Opus 5.5 comme « basically perfect - right first time every time ».
En face, drbscl rappelle qu’Opus 5.5 est « even more verbose » d’après Artificial Analysis. margorczynski défend Astra : « Astra will usually do that using less token and offer a better quality solution ». jasbury, converti : « I finally decided to try Astra. It handled all of my prompts in one go. » Et Someone1234 résume le débat de réglage : le medium d’Opus 5.5 « actually can make sense », mais le coût du max est « completely unhinged ».
Ces avis sont cohérents avec les mesures. Astra consomme beaucoup de quota parce que son token coûte cher (50 $ le million en sortie). Opus 5.5 consomme beaucoup parce qu’il écrit beaucoup, surtout au maximum. Ce ne sont pas les mêmes défauts, et ils ne se corrigent pas avec le même bouton.
Attention
Opus 5.5 a cinq jours. Aucune mesure indépendante ne compare encore la consommation réelle d’un forfait Claude Max à celle d’un ChatGPT Pro sur le même travail : il n’y a que des témoignages. Les chiffres Anthropic sont des chiffres constructeur, avec des réglages d’effort différents pour Opus et Astra. Et l’histoire récente invite à la prudence : les modèles bougent après leur lancement (on a enquêté sur ce cycle). Le tracker communautaire livenerf suit Opus 5.5 depuis le 22 septembre ; premier verdict attendu vers le 24 octobre.
Verdict
En intelligence brute, Opus 5.5 est devant tout le monde, Astra compris, et de loin devant Sol, le modèle par défaut de Codex. En consommation, il n’écrase Astra qu’à une condition : ne pas le pousser au maximum. À l’effort « high », il est plus intelligent, moins cher et plus sobre qu’Astra au maximum. Au maximum, il reste le plus fort, mais aussi le plus gourmand du marché.
Pour un abonné, la conclusion pratique est simple : le réglage compte autant que le modèle. Opus 5.5 en « high » ou « medium » est aujourd’hui le meilleur rapport intelligence / quota mesuré. En « max », c’est une Formule 1 : imbattable, et elle boit en conséquence.
Sources
- Anthropic, Claude Opus 5.5, 22 septembre 2026 (ouvre anthropic.com dans un nouvel onglet)
- Anthropic, documentation Opus 5.5 (ouvre platform.claude.com dans un nouvel onglet)
- Artificial Analysis, Claude Opus 5.5, 22 septembre 2026 (ouvre artificialanalysis.ai dans un nouvel onglet)
- Artificial Analysis, Claude Opus 5.5 (high) (ouvre artificialanalysis.ai dans un nouvel onglet)
- Artificial Analysis, Claude Opus 5.5 (max) (ouvre artificialanalysis.ai dans un nouvel onglet)
- Artificial Analysis, Claude Opus 5.5 (medium) (ouvre artificialanalysis.ai dans un nouvel onglet)
- Artificial Analysis, GPT-6 Astra (ouvre artificialanalysis.ai dans un nouvel onglet)
- Artificial Analysis, GPT-6 Sol (ouvre artificialanalysis.ai dans un nouvel onglet)
- Artificial Analysis, Coding Agent Index (ouvre artificialanalysis.ai dans un nouvel onglet)
- OpenAI, Introducing GPT-6 Sol and Luna, 22 septembre 2026 (ouvre openai.com dans un nouvel onglet)
- Mixed News, Claude Opus 5.5 : prix et limites d’usage (ouvre mixed-news.com dans un nouvel onglet)
- livenerf, suivi communautaire d’Opus 5.5 (ouvre github.com dans un nouvel onglet)
- Hacker News : fil de lancement (ouvre news.ycombinator.com dans un nouvel onglet), cbg0 (ouvre news.ycombinator.com dans un nouvel onglet), notatoad (ouvre news.ycombinator.com dans un nouvel onglet), drbscl (ouvre news.ycombinator.com dans un nouvel onglet), margorczynski (ouvre news.ycombinator.com dans un nouvel onglet), Someone1234 (ouvre news.ycombinator.com dans un nouvel onglet), jasbury (ouvre news.ycombinator.com dans un nouvel onglet), drcongo (ouvre news.ycombinator.com dans un nouvel onglet)
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.
À lire aussi
- Abonnements IA : enquête sur le cycle lancement, nerf, resetUn modèle sort, il est brillant et ne consomme rien. Quelques semaines plus tard, il « devient bête » et le quota fond. On a repris les dossiers Anthropic et OpenAI 2025-2026 : aucune preuve de dégradation volontaire, mais une longue liste de changements silencieux reconnus après coup.
- Les resets d’OpenAI sont des cadeaux empoisonnés55 resets de quotas Codex recensés depuis septembre 2025, un tous les 6,9 jours. Ils réparent des bugs sans les chiffrer, décalent la semaine de l’abonné, servent d’argument de vente et ancrent une consommation que le forfait ne garantit pas. Ce qu’en dit la communauté.
- ChatGPT Pro Max à 500 $ : le « x50 » d’OpenAI n’est encore qu’une fuiteLe plan « promax » est apparu dans le code de ChatGPT et dans un commit public de Codex le 25 septembre 2026. Une capture l’affiche à 500 $ hors taxes, « Fastest Work and Codex ». Le 50× n’est qu’un calcul de blog. Annonce possible au DevDay du 29.