News · Logiciel
EmbeddingGemma 2 : Google veut la recherche multimodale hors ligne
Google publie EmbeddingGemma 2, un modèle ouvert de 740 millions de paramètres sous licence Apache 2.0. Il convertit texte, code, images, vidéo et audio en vecteurs comparables pour chercher dans ses fichiers sans cloud.
Le 6 octobre 2026, Google a publié EmbeddingGemma 2 (ouvre blog.google dans un nouvel onglet), un modèle ouvert de 740 millions de paramètres. Il ne génère pas de texte : il transforme du texte, du code, des images, de la vidéo et de l'audio en suites de nombres comparables entre elles. Le but est de faire de la recherche par similarité directement sur un téléphone ou un PC, sans envoyer ses fichiers dans le cloud. Le modèle est sous licence Apache 2.0 et déjà téléchargeable.
Info
Contrôle du 7 octobre 2026. Sources primaires lues : annonce de Google (ouvre blog.google dans un nouvel onglet), fiche du modèle sur Hugging Face (ouvre huggingface.co dans un nouvel onglet). Les scores cités sont ceux de Google, non vérifiés de façon indépendante. Non confirmé à cette date : la date d'arrivée dans le catalogue Model Garden de Google Cloud (annoncée « bientôt ») et les performances réelles sur un PC ou un Mac grand public.
Un embedding, c'est quoi ?
Un embedding (ou « représentation vectorielle ») est une liste de nombres qui résume le sens d'un contenu. Pour EmbeddingGemma 2, c'est une liste de 768 nombres. Deux contenus proches par le sens donnent des listes proches. Il suffit alors de mesurer la distance entre ces listes pour trouver ce qui se ressemble.
Prenons un exemple concret. Ton application de photos calcule une fois l'embedding de chaque image, en local. Tu tapes « le chien sur la plage l'été dernier ». La phrase est convertie à son tour, puis comparée aux photos : les plus proches remontent, même si aucune n'a de légende. Le même principe vaut pour retrouver une note, un extrait de code ou un passage d'un enregistrement audio, le tout hors ligne.
La nouveauté de cette version, c'est que texte, code, images, vidéo et audio partagent le même espace. Une requête écrite peut donc retrouver une image ou un moment dans une vidéo.
Ce que Google annonce
D'après Google (ouvre blog.google dans un nouvel onglet) et la fiche du modèle (ouvre huggingface.co dans un nouvel onglet) :
- Modulaire : 270 millions de paramètres suffisent pour le texte seul. Les encodeurs image (170 M) et audio (300 M) sont optionnels.
- Mémoire : avec quantification (compression des poids), environ 191 Mo de RAM pour le texte seul et environ 567 Mo pour le modèle complet, mesurés par Google sur un Pixel 11 Pro.
- Contexte de 8 192 tokens, quatre fois plus que la première version. Cela représente environ 29 images, 58 images de vidéo ou un peu plus de 5 minutes d'audio.
- Vecteurs réductibles de 768 à 512, 256 ou 128 nombres, pour diviser jusqu'à six fois la place occupée.
- Plus de 100 langues gérées, selon la fiche Hugging Face.
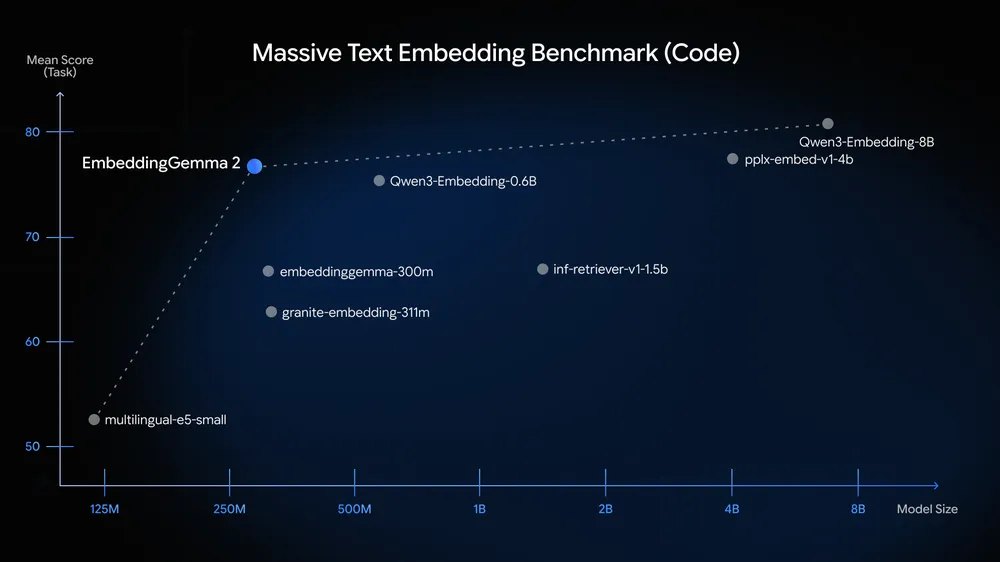
Crédit : Google (ouvre blog.google dans un nouvel onglet), graphique publié avec l'annonce du 6 octobre 2026.
Sur le code, Google annonce un score MTEB Code de 78,68, contre 68,76 pour EmbeddingGemma 1. Il dit aussi battre certains modèles spécialisés deux fois plus gros sur l'image et l'audio.
Pour qui, et avec quelles limites
C'est d'abord un outil de développeur. Il sert à construire une recherche locale dans une médiathèque, à indexer un projet de code, ou à alimenter un RAG, c'est-à-dire un assistant qui va chercher des documents avant de répondre. Google l'associe à son modèle génératif Gemma 4. Les poids sont sur Hugging Face (ouvre huggingface.co dans un nouvel onglet), Kaggle et Ollama. Il fonctionne avec transformers, sentence-transformers, llama.cpp, LM Studio ou MLX sur Mac. Le modèle est gratuit, et l'annonce ne mentionne aucune restriction pour la France ou l'UE.
La fiche liste plusieurs limites. Les performances varient selon les langues. Il faut ajouter de courts préfixes de tâche au texte pour obtenir la meilleure qualité. Le calcul en float16 donne des résultats faux sans message d'erreur ; il faut utiliser bfloat16 ou float32. Enfin, réduire les vecteurs à 128 nombres dégrade nettement la qualité sur les images, la vidéo et l'audio.
Notre lecture
Analyse. Ce n'est pas un modèle que l'on « utilise » directement, mais une brique qui peut rendre la recherche locale enfin utile. Moins de 600 Mo pour chercher dans ses photos, ses vidéos et ses notes sans cloud, c'est un bon argument pour la vie privée. Reste à voir si les applications grand public l'adopteront. Sur Mac, il rejoint l'écosystème MLX dont nous avons parlé en septembre.
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.