News · Industrie
Maths : OpenAI publie 722 manuscrits d'un modèle interne, avec preuves Lean
Le 6 octobre 2026, OpenAI a publié sur GitHub 722 manuscrits mathématiques (372 familles) produits par un modèle interne, dont 162 avec preuve vérifiée en Lean. Ce qui est revendiqué, ce que Lean garantit, et les réserves des mathématiciens.
Le 6 octobre 2026, OpenAI a publié sur GitHub un vaste ensemble de résultats mathématiques produits par un modèle interne non commercialisé. Le dépôt openai/math (ouvre github.com dans un nouvel onglet) contient 722 manuscrits regroupés en 372 « familles », des preuves partiellement vérifiées par ordinateur et des détails sur la façon dont ils ont été obtenus. Les mathématiciens saluent la transparence, mais doutent encore de la nouveauté réelle de nombreux résultats.
Info
Contrôle du 8 octobre 2026. Sources primaires lues : annonce d'OpenAI (ouvre openai.com dans un nouvel onglet), dépôt GitHub openai/math (ouvre github.com dans un nouvel onglet) (README, catalogue Lean), recommandations de l'AGMAI (ouvre agmai.org dans un nouvel onglet). Presse : Scientific American (ouvre scientificamerican.com dans un nouvel onglet), Fortune (ouvre fortune.com dans un nouvel onglet). Non confirmé : le nom du modèle, sa date de sortie, et la validité des manuscrits non formalisés. Yatofix n'a pas recompilé les preuves Lean.
Ce qu'OpenAI met sur la table
Selon le README du dépôt (ouvre github.com dans un nouvel onglet), le modèle a reçu environ 4 000 problèmes au fil de l'évaluation. OpenAI n'a gardé que les résultats jugés assez significatifs. Chaque résultat aurait demandé en moyenne l'équivalent de trois heures de réflexion de ChatGPT Pro. OpenAI ne détaille pas le calcul problème par problème.
Le dépôt fournit les PDF et sources LaTeX, une notice de citation BibTeX par manuscrit et dix résumés du raisonnement du modèle. Ceux-ci couvrent notamment les conjectures de Mahler et l'isomorphisme des facteurs de groupes libres. OpenAI promet un historique des versions : les corrections s'ajouteront sans effacer les anciennes.
Selon Scientific American (ouvre scientificamerican.com dans un nouvel onglet), un porte-parole affirme que presque tous les résultats viennent d'un seul prompt donné à un seul agent, certains après plusieurs tentatives. Le README reconnaît des exceptions, dont des travaux sur l'hypothèse de Riemann rédigés en partie par des humains.
Ce que Lean garantit, et ce qu'il ne garantit pas
Lean est un langage qui permet à un ordinateur de vérifier une preuve ligne par ligne. Le catalogue de formalisation (ouvre github.com dans un nouvel onglet) couvre le résultat principal de 162 manuscrits sur 722. Pour chacun, un fichier « défi » énonce le théorème sans preuve. L'outil Comparator vérifie que la preuve d'OpenAI démontre exactement cet énoncé, avec les seuls axiomes standards.
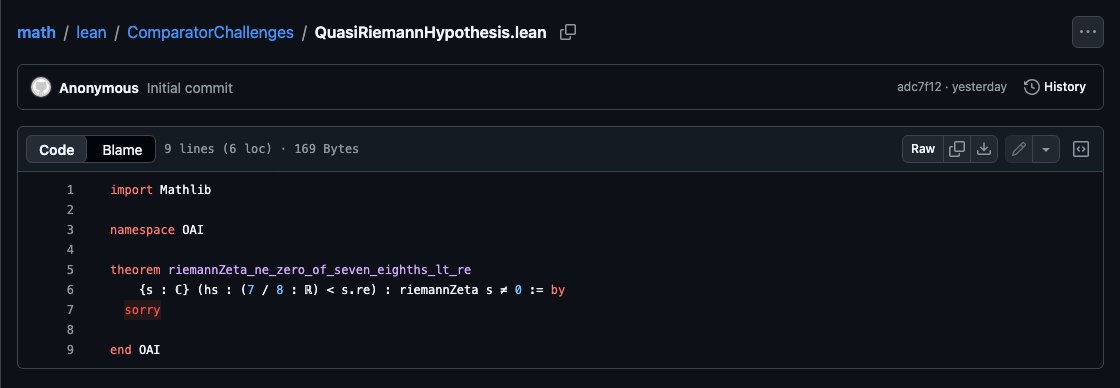
Crédit : capture Yatofix du dépôt GitHub openai/math (ouvre github.com dans un nouvel onglet), 8 octobre 2026.
Exemple : ce défi affirme que la fonction zêta de Riemann n'a aucun zéro quand la partie réelle dépasse 7/8. Si la preuve tient, ce serait un pas majeur vers l'hypothèse de Riemann.
Lean garantit la logique, pas le reste. Il ne dit pas si l'énoncé formel traduit fidèlement le problème du manuscrit. Il ne juge ni l'originalité ni l'intérêt du résultat. Et 560 manuscrits n'ont pas de preuve formelle : OpenAI écrit lui-même que certains pourraient contenir des erreurs.
La réaction des mathématiciens
Les avis sont partagés. Selon Scientific American, Andrew Sutherland (MIT) estime qu'il faut traiter l'idée d'un « seul prompt » comme non vérifiée tant que le modèle n'est pas reproductible. Daniel Litt (Toronto) juge au contraire utile que ces réponses soient publiées plutôt que gardées secrètes.
D'après Fortune (ouvre fortune.com dans un nouvel onglet), Terence Tao (UCLA) juge le rythme des laboratoires « insane » (« délirant »). Il craint que des problèmes soient résolus par des gens sans intérêt pour le domaine. Tristan Buckmaster (NYU) redoute des travaux humains en cours repris et terminés par l'IA.
Le précédent compte. En août, Scientific American rapportait (ouvre scientificamerican.com dans un nouvel onglet) que deux des dix résultats publiés par OpenAI reprenaient des idées déjà parues, sans citation suffisante.
L'Advisory Group on Mathematics and AI (AGMAI), basé à l'Institute for Advanced Study, avait demandé le 29 septembre (ouvre agmai.org dans un nouvel onglet) un dépôt hors du contrôle des laboratoires, les prompts et le coût de chaque résultat, et les échecs. OpenAI publie sur son propre GitHub et donne des moyennes. Le groupe précise que son rôle ne vaut pas validation.
Notre lecture
Analyse. La forme progresse : versions, citations, Lean et traces sont plus sérieux qu'un communiqué. Mais 372 familles, c'est un volume que personne ne peut relire vite. Distinguer exercices difficiles et vrais problèmes ouverts prendra des mois. Le modèle n'est ni nommé ni disponible, en France comme ailleurs, ce qui empêche toute reproduction. Pour le contexte, voir la sortie de GPT-6 Astra et nos articles sur OpenAI.
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.