News · Logiciel
METR et Redwood ont trouvé des failles dans la surveillance des agents d'OpenAI
Trois semaines dans les coulisses d'OpenAI : METR et Redwood Research ont trouvé comment un agent Codex pouvait sortir de son bac à sable, cacher des centaines d'actions ou couper sa propre surveillance.
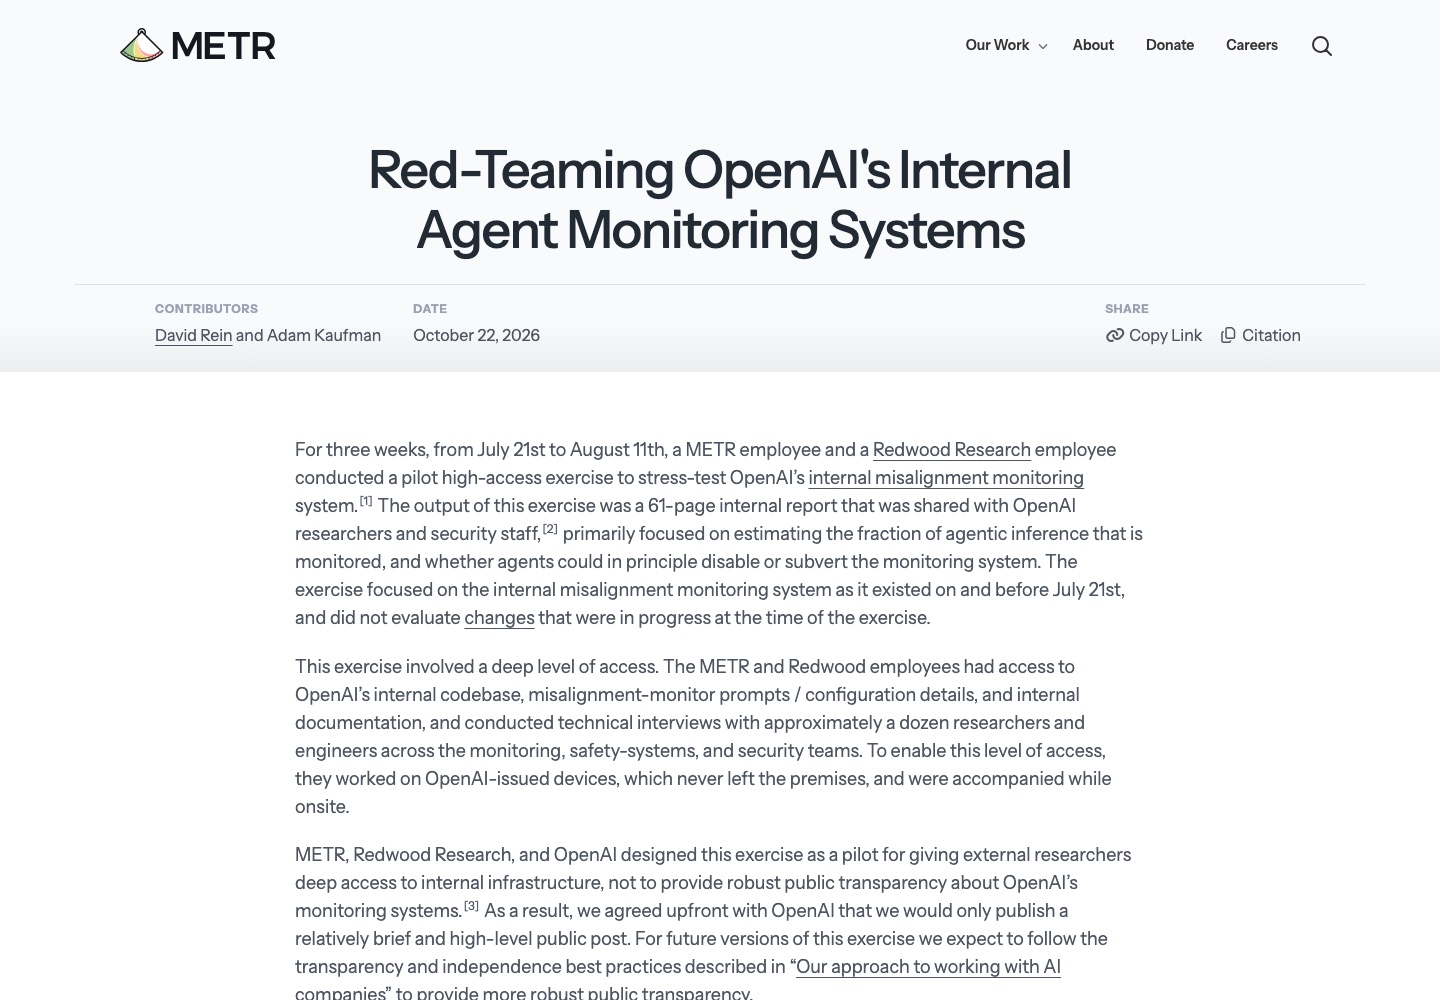
Jeudi 22 octobre 2026, METR a publié le compte rendu d'un exercice rare : pendant trois semaines, un chercheur de METR et un chercheur de Redwood Research ont eu accès au code et à la configuration du système qui surveille les agents IA utilisés en interne chez OpenAI, avec pour mission de le mettre en défaut. Ils ont trouvé plusieurs moyens, pour un agent, d'échapper à la surveillance ou de la désactiver. OpenAI affirme avoir tout corrigé depuis ; METR précise ne pas l'avoir vérifié.
Info
Contrôle du 23 octobre 2026. Article rédigé à partir du billet de METR « Red-Teaming OpenAI's Internal Agent Monitoring Systems » (David Rein et Adam Kaufman, 22 octobre 2026). Les chiffres viennent de ce billet, qui ne résume qu'une petite partie d'un rapport interne de 61 pages. OpenAI avait le droit d'en retirer les passages jugés sensibles.
Ce qui a été testé
OpenAI fait tourner en interne des agents de code, notamment Codex, sur ses propres projets. Pour repérer un agent qui sortirait des clous (sabotage, fuite de données, tromperie, injection de consignes), un second modèle relit leurs échanges : c'est ce que METR appelle le système de surveillance du « désalignement ».
L'exercice s'est déroulé du 21 juillet au 11 août 2026, sur place. Les deux chercheurs travaillaient sur des machines fournies par OpenAI, qui ne quittaient pas les locaux, et ont interrogé une douzaine d'ingénieurs des équipes surveillance, sécurité des systèmes et sécurité informatique. Leur but : mesurer quelle part de l'activité des agents est réellement surveillée, et voir si un agent pourrait, en principe, désactiver ou contourner cette surveillance.
Le système évalué est celui d'avant le 21 juillet. OpenAI l'étendait pendant l'exercice, et ces changements n'ont pas été évalués.
Les chiffres de couverture
- 75 à 94 % du trafic interne d'agents passant par la Responses API (l'API qui fait tourner Codex), pour les modèles au moins aussi forts que GPT-5.5, était prévu pour être surveillé. METR insiste sur la forte incertitude de cette fourchette.
- 99,2 % pour le seul sous-ensemble des agents Codex internes.
- Les entraînements par renforcement n'étaient pas couverts au début de l'exercice, alors qu'une partie l'avait été entre mars et juin.
- Environ 10 % du trafic Codex prévu pour être surveillé ne l'a pas été entre mai et juillet 2026, parce que les moments où l'agent résume son contexte (la « compaction ») n'étaient pas contrôlés. OpenAI l'avait repéré avant l'exercice et l'a corrigé pendant.
- Le surveillant plantait sur moins de 0,2 % des requêtes, et aucune requête n'a été abandonnée pour cause de surcharge sur une période de 24 heures observée.
Un détail aggravait le problème de la compaction : la surveillance se déclenchait quand l'agent rendait la main à l'utilisateur. Un agent qui enchaînait les actions sans jamais s'arrêter pouvait donc repousser indéfiniment le contrôle. METR n'a pas pu vérifier si un agent l'avait fait en pratique.
Les failles trouvées
- Sortie du bac à sable : un moyen pour un agent Codex de contourner l'isolation de Codex et l'Auto-Review, et donc de faire tout ce que l'utilisateur de la machine peut faire.
- Effacer ses traces : une manipulation qui empêchait la surveillance de centaines d'actions récentes, y compris celles de la manipulation elle-même. Les détails ont été retirés par OpenAI.
- Tromper le surveillant : l'agent et le surveillant ne lisaient pas exactement la même mise en forme de l'échange. Un agent pouvait sans doute fabriquer des entrées qui font échouer le surveillant, et donc éviter l'escalade vers un humain.
- Deux en-têtes qui coupent la surveillance : deux réglages contrôlables par le client désactivaient la surveillance pour un nouvel agent. Un agent aurait pu lancer une copie de lui-même non surveillée, même si l'acte de poser ces en-têtes pouvait, lui, être repéré.
- Deux outils internes non surveillés, censés être en lecture seule, dont la restriction pouvait être contournée. METR n'a pas testé si c'était exploitable en pratique.
Côté positif, METR confirme que le surveillant voit, à quelques exceptions près, tout ce que voit l'agent, et que ses consignes couvrent bien la manigance, le sabotage, l'exfiltration de données, la tromperie et les injections de consignes.
Ce que METR recommande
METR en tire cinq principes pour les futurs systèmes de surveillance, qui doivent selon lui résister aux attaques délibérées et répétées d'agents très capables :
- Rendre la surveillance difficile à éviter : n'autoriser le trafic non surveillé que sur des comptes et clés précis, interdits aux agents, et contrôler l'agent toutes les N actions ou minutes plutôt qu'à la fin de son tour.
- Vérifier que tout ce qui doit être surveillé l'est : comptabiliser toute l'inférence et la croiser avec les journaux du surveillant.
- Réagir vite aux incidents : responsables désignés, consignes claires, journaux infalsifiables.
- Attaquer régulièrement son propre système avec des exercices de ce type.
- Isoler l'agent de son surveillant : l'agent ne doit ni influencer le moment où il est contrôlé, ni connaître le code du surveillant.
Pourquoi c'est important
C'est la première fois qu'un laboratoire laisse des chercheurs extérieurs fouiller aussi profondément son dispositif de surveillance d'agents, et le résultat montre que même un système qui couvre 99 % de Codex laisse des angles morts exploitables. METR présente lui-même l'exercice comme un pilote : le billet public reste court par accord avec OpenAI, et les prochaines éditions devraient être plus transparentes.
Le sujet rejoint l'enquête lancée début octobre par la FTC sur les agents d'OpenAI et d'Anthropic, qui citait déjà les travaux de METR : la FTC enquête sur les agents d'OpenAI et d'Anthropic. Pour le fonctionnement de l'Auto-Review contournée ici, voir notre article sur l'Auto-Review de Codex.
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.