News · Logiciel
Tencent Hy Memory 2.0 : une mémoire longue open source pour agents
Tencent ouvre Hy Memory 2.0 en Apache-2.0 le 17 octobre 2026 : mémoire en trois scènes, chaîne de diffs pour le code et MemHub pour relier vos outils IA.
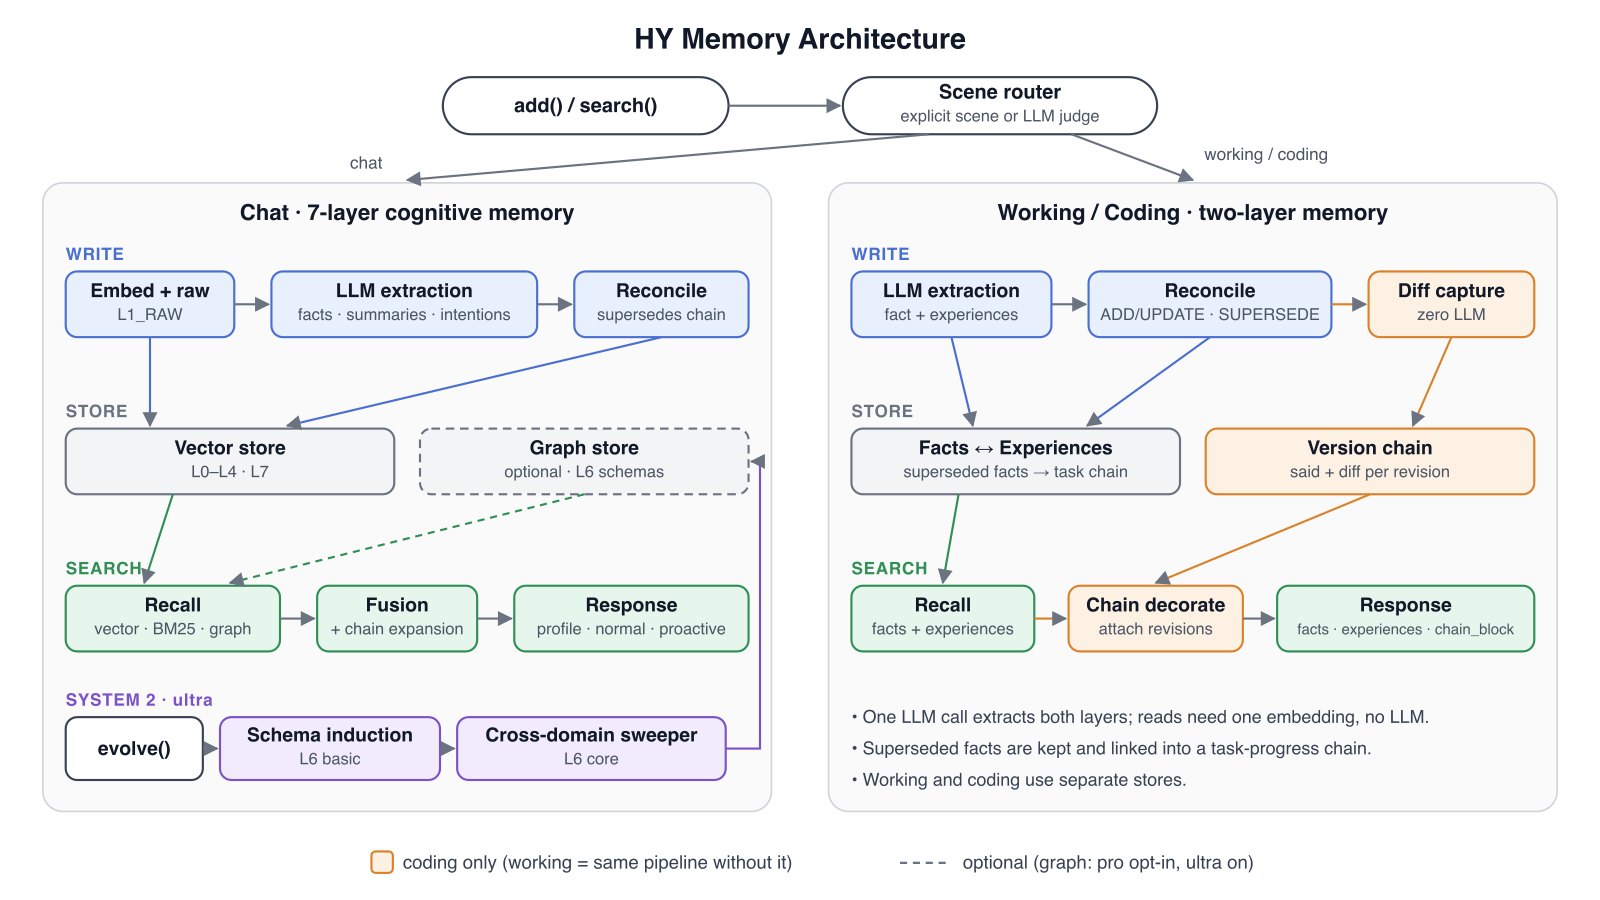
Le 17 octobre 2026, Tencent Hunyuan a publié sur PyPI la version 2.0.3 de Hy Memory, son moteur de mémoire longue pour agents, désormais open source en licence Apache-2.0, avec son monorepo, l'outil local MemHub et un modèle dédié, Hy-Memory-30B-A3B. L'idée : donner aux agents une mémoire structurée qui distingue conversation, travail et code, au lieu d'un simple entrepôt de textes retrouvés par similarité.
Info
Contrôle du 17 octobre 2026. Sources primaires : dépôt GitHub Tencent-Hunyuan/Hy-Memory (ouvre github.com dans un nouvel onglet) (README et section « Latest News » lus en entier), page PyPI de la version 2.0.3 (ouvre pypi.org dans un nouvel onglet) (téléversée le 17 octobre) et fiche Hugging Face du modèle (ouvre huggingface.co dans un nouvel onglet) (créée le 15 octobre). Les architectures décrites sont celles du projet ; aucun banc indépendant n'était publié à cette date.
Trois mémoires, pas une
Hy Memory route chaque écriture vers l'une de trois « scènes ». Pour la conversation, une hiérarchie en couches va des dialogues bruts aux faits atomiques, résumés, schémas et intentions à échéance, avec réconciliation des contradictions. Pour le travail outillé, deux couches suffisent : les faits de la session — ce qui a été fait, avec quel résultat — et les expériences réutilisables pour les tâches semblables. Pour le code, Tencent ajoute une chaîne d'évolution des versions : les vrais diffs de chaque révision sont conservés sans appel de modèle, pour retrouver aussi ce qui a été essayé puis abandonné.
Trois modes règlent le coût : « lite » se contente d'embeddings bruts sans appels de LLM, « pro » ajoute extraction et réconciliation par LLM, « ultra » active un second système qui induit des schémas entre domaines. Côté stockage, ChromaDB par défaut, Qdrant et FAISS en option, Kuzu ou Neo4j pour le graphe.
MemHub et un modèle entraîné à écrire la mémoire
MemHub est l'autre pièce livrée avec la 2.0 : un outil local, bureau et ligne de commande, qui unifie les historiques de conversation et les traces de code d'applications IA autorisées par l'utilisateur — Claude Code, Cursor, Codex, OpenCode et Qwen Code sont cités — pour permettre des rappels de mémoire d'un outil à l'autre. Le modèle Hy-Memory-30B-A3B, un mélange d'experts de 30 milliards de paramètres dont 3 milliards actifs, est entraîné par apprentissage par renforcement « attribué » spécialement pour l'extraction de mémoire et la réconciliation des conflits, avec rapport technique public.
C'est exactement le chaînon qui manque aux environnements de code actuels, que nous comparions cet automne : chacun garde son historique, aucun ne partage ses apprentissages durablement.
Notre lecture
Analyse. Hy Memory arrive dans une semaine très « poids et outils ouverts », entre l'ouverture de Muse Spark par Meta et les mises à jour agentiques de DeepSeek. Sa contribution intéressante n'est pas le modèle, c'est la chaîne de diffs : pour un agent de code, se souvenir des versions rejetées évite de refaire les mêmes impasses d'une session à l'autre. Avant de brancher MemHub sur des historiques contenant du code métier, lis sa documentation de confidentialité et ses périmètres d'autorisation : une mémoire partagée entre outils est aussi une surface de fuite partagée.
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.