News · Logiciel
Claude Code vs Cursor vs Codex : trois surfaces, un métier
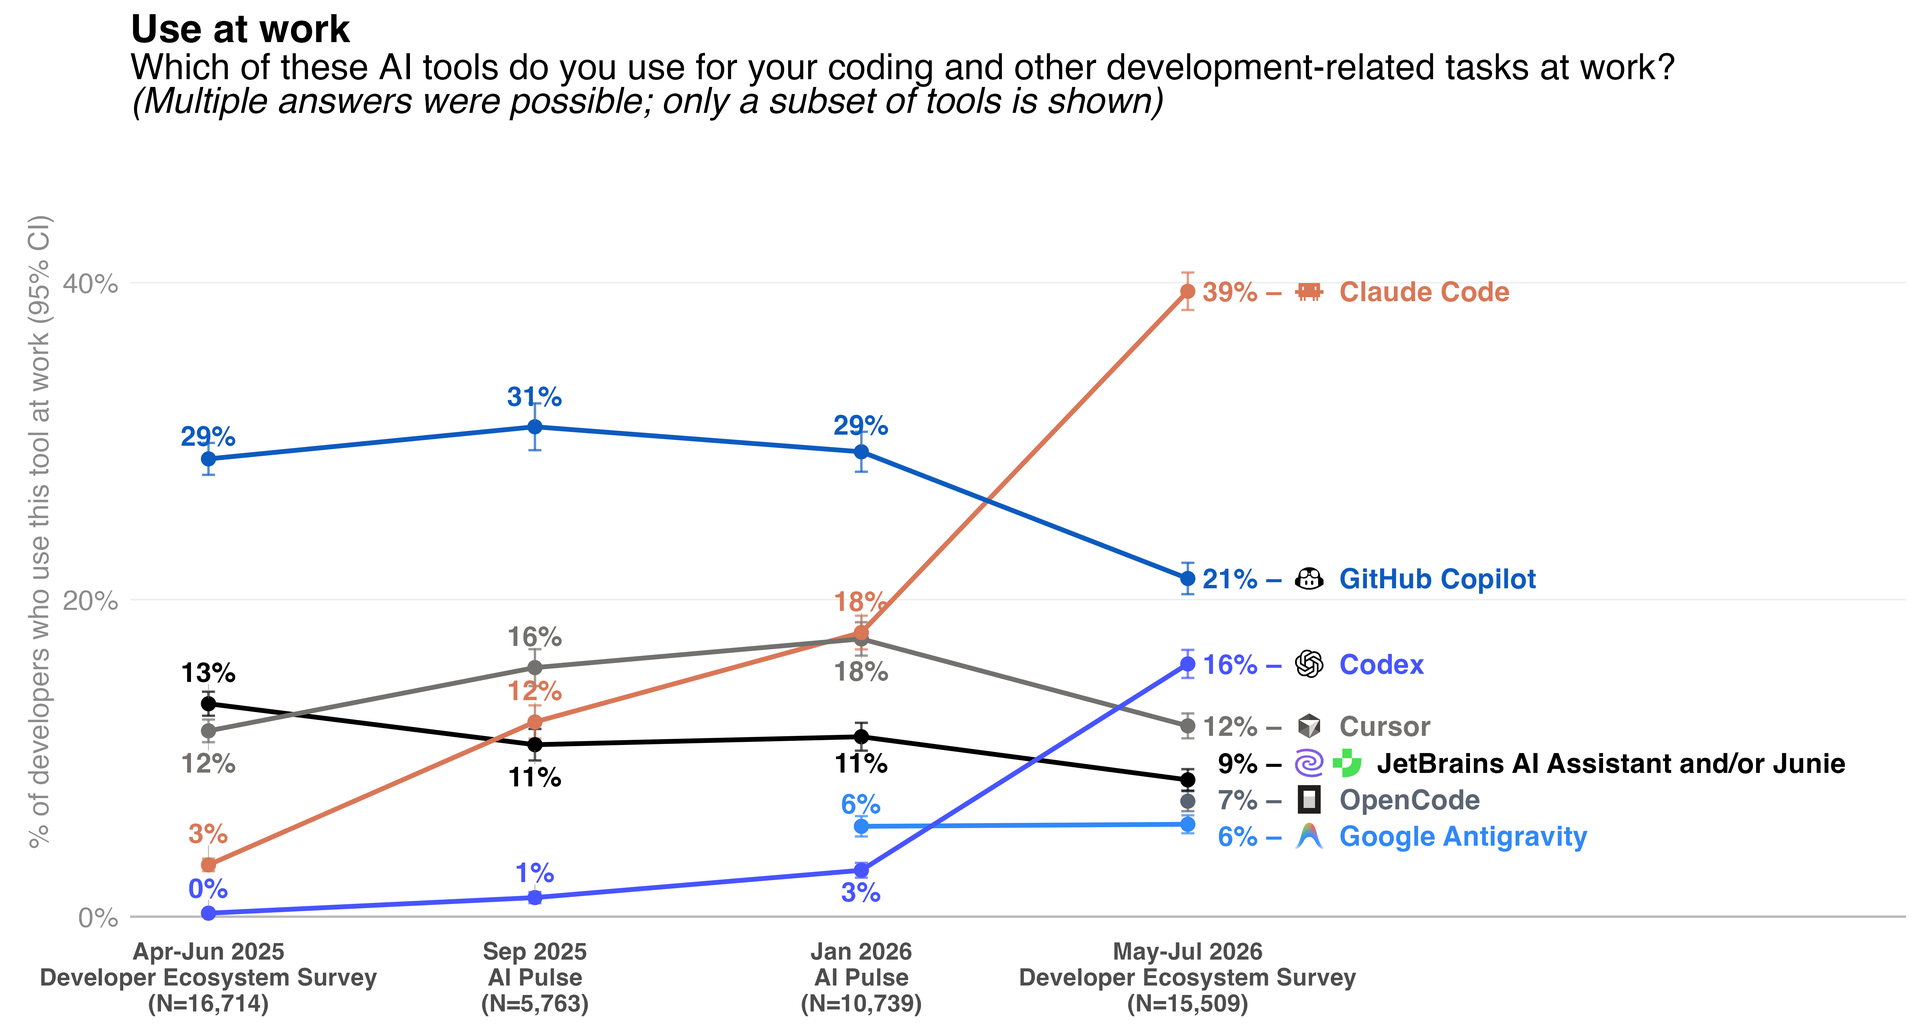
JetBrains, mai–juillet 2026 : 90 % des développeurs pro utilisent un agent de code chaque semaine. Claude Code 39 %, Codex 16 %, Cursor 12 %. CursorBench 4.0 : Fable 5.1 à 51,8, Composer 2.5 à 27,7.
Le métier a un nom de moins en moins utile : « coder avec une IA ». En 2026, ça veut dire laisser un agent lire le dépôt, poser des fichiers, lancer des tests, ouvrir une PR. Trois produits se disputent ce geste. Ils ne se ressemblent pas.
Claude Code vit d’abord dans le terminal, aussi dans l’IDE, le bureau et le web. Cursor est un éditeur, fork de VS Code, avec un modèle maison (Composer) et les frontières des autres. Codex est l’agent OpenAI : CLI, app, extension, cloud. Même job. Trois surfaces.
Info
Contrôle du 20 septembre 2026. Adoption : JetBrains Research (ouvre blog.jetbrains.com dans un nouvel onglet), 18 août, Developer Ecosystem Survey 2026, plus de 15 000 développeurs pro, terrain mai–juillet (N = 15 509 pour la vague). Banc : CursorBench 4.0 (ouvre cursor.com dans un nouvel onglet), publié le 10 septembre, tâches longues tirées de sessions Cursor. Codex : page produit (ouvre openai.com dans un nouvel onglet) et tarifs (ouvre learn.chatgpt.com dans un nouvel onglet). Fable 5.1 est aussi dans Cursor (forum (ouvre forum.cursor.com dans un nouvel onglet), 1er septembre). 4.0 n’est pas comparable à CursorBench 3.2.
Qui l’utilise vraiment, pas qui en parle
JetBrains, mai–juillet 2026 : 90 % des développeurs professionnels utilisent un agent de code au travail au moins une fois par semaine, 68 % tous les jours. Ce n’est plus un gadget de keynote.
| Outil | Usage au travail, mai–juil. 2026 | Janvier 2026 | Notoriété, mai–juil. |
|---|---|---|---|
| Claude Code | 39 % (47 % aux États-Unis) | 18 % | 79 % |
| GitHub Copilot | 21 % | 29 % un an plus tôt | 79 % (86–90 % UE / UK / US) |
| Codex | 16 % | 3 % | 65 % (27 % en janvier) |
| Cursor | 12 % | 18 % | 75 % (69 % en janvier) |
| JetBrains AI / Junie | 9 % | — | 53 % |
| OpenCode | 7 % | — | 42 % |
| Google Antigravity | 6 % | 6 % | 47 % |
Claude Code est l’outil le plus utilisé pour 31 % des répondants, soit une conversion d’environ 80 % de ceux qui s’en servent au travail. Codex a multiplié l’usage par cinq en six mois. Cursor a gagné en notoriété et perdu en usage (chute la plus nette en Chine : 28 % → 16 %). Copilot reste le nom que tout le monde connaît, plus l’outil que tout le monde ouvre.
Ce n’est pas un classement de qualité. C’est un classement de sièges occupés, sur un terrain mai–juillet — avant Astra, avant CursorBench 4.0, avant la fin du boost Claude Code.
CursorBench 4.0 : le modèle, pas la fenêtre
Le 10 septembre, Cursor remplace le jeu 3.2 par CursorBench 4.0 : tâches longues, multi-fichiers, tirées de vraies sessions, plus dures. Tous les scores baissent. Lee Robinson, chez Cursor, le dit au moment du passage. On ne compare pas 73,4 % (Fable 5.1 Max sur 3.2) à 51,8 % (Fable 5.1 Max sur 4.0).
Meilleure config publiée par famille, page officielle lue le 20 septembre :
| Modèle | Score 4.0 | Coût moyen / tâche | Tokens / tâche |
|---|---|---|---|
| Claude Fable 5.1 Max | 51,8 % | 17,28 $ | 117 236 |
| Claude Opus 5 Max | 46,6 % | 11,95 $ | 85 384 |
| GPT-5.6 Sol Max | 41,7 % | 8,23 $ | 42 944 |
| Muse Spark 1.3 Max | 41,6 % | 2,64 $ | 52 005 |
| Grok 4.6 Extra High | 41,4 % | 6,10 $ | 49 814 |
| GPT-5.6 Terra Max | 41,3 % | 5,14 $ | 60 814 |
| Gemini 3.8 Flash High | 39,6 % | 4,70 $ | 162 565 |
| GPT-5.6 Luna Max | 35,9 % | 1,03 $ | 87 284 |
| Claude Sonnet 5 Max | 34,1 % | 7,17 $ | 149 257 |
| Composer 2.5 | 27,7 % | 0,68 $ | 17 347 |
Fable 5.1 Extra High tient 51,6 % à 13,01 $. Composer 2.5, le modèle de Cursor, est le moins cher du tableau et le moins haut. L’écart n’est pas une surprise : Cursor le vend comme un modèle rapide, pas comme le plafond. Fable 5.1 est dans Cursor depuis le 1er septembre. Claude Code n’a pas l’exclusivité du meilleur score du banc de Cursor.
GPT-6 Astra n’apparaît pas dans ce snapshot 4.0. OpenAI, de son côté, le place au-dessus de Fable 5.1 sur Terminal-Bench 4.0 (57,9 % contre 55,8 %), banc constructeur. Deux harnais, deux classements. On ne les additionne pas.
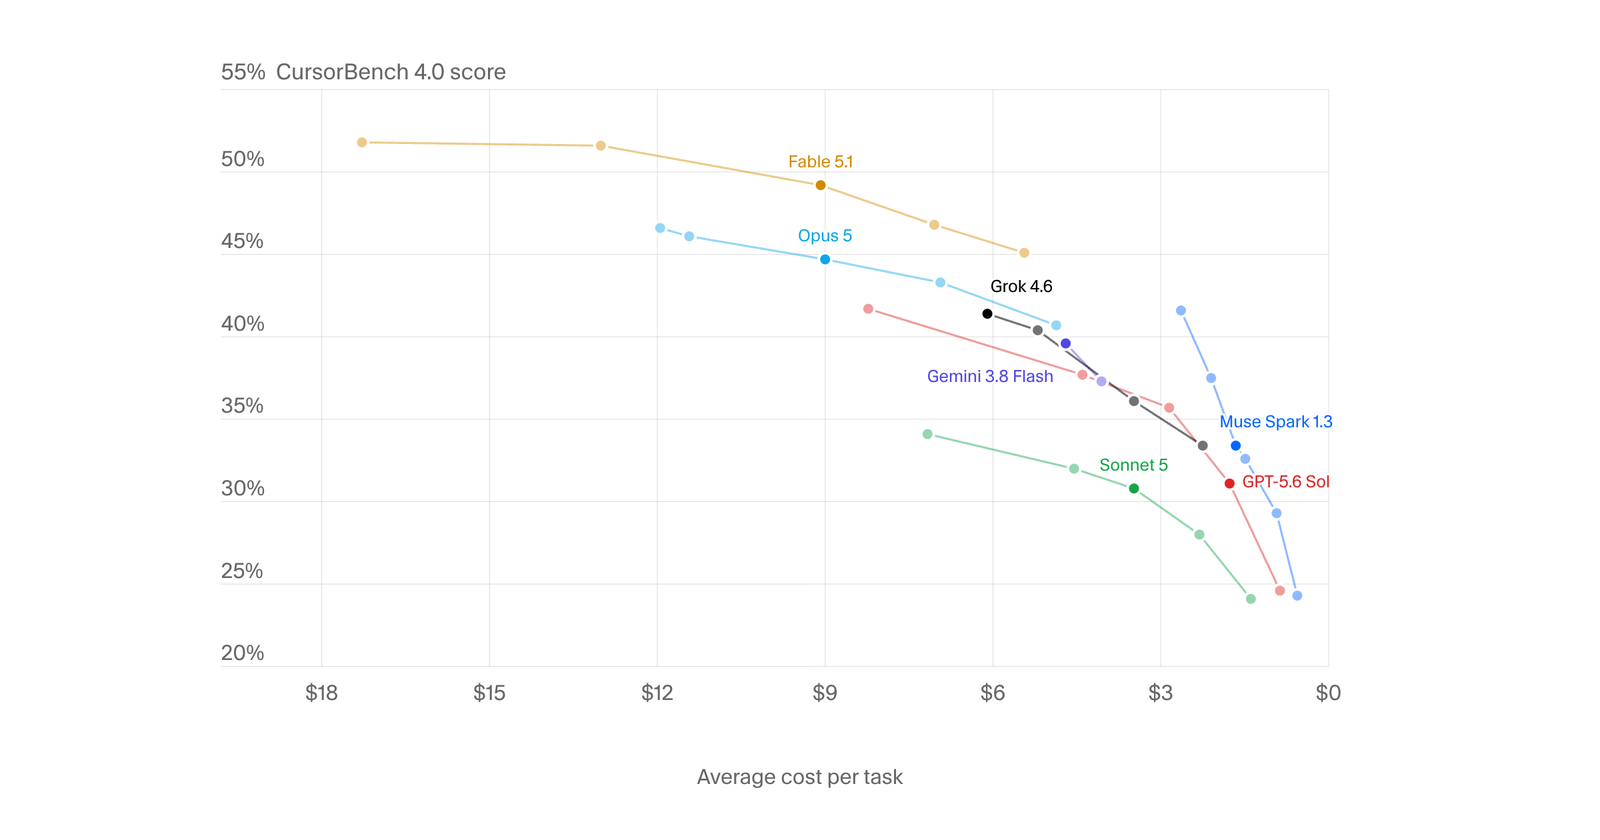
Crédit : Cursor, CursorBench 4.0 (ouvre cursor.com dans un nouvel onglet), 10 septembre 2026. Score contre coût moyen par tâche. Capturé depuis le visuel Open Graph officiel.
Trois surfaces, un geste
Claude Code. Agent dans le répertoire. On lui parle, il lit, il patch, il lance. CLI d’abord, puis extension, bureau, web. Forfaits Anthropic : Pro, Max 5×, Max 20×. Le 14 septembre, le quota hebdomadaire est redescendu d’un étage — on l’a détaillé. Fable 5.1 est le haut de sa pile.
Cursor. Un IDE. Complétion, diffs inline, agent, et depuis le 10 septembre un mode Projects : un coordinateur qui ne code pas, des sous-agents qui codent, souvent dans le cloud. On peut y coller Fable, Opus, Sol, Grok, Composer. Le produit n’est pas « un modèle ». C’est la fenêtre où l’on reste collé au fichier. Composer 2.5 coûte 0,68 $ la tâche sur le banc 4.0. Les leaks Composer 3, on les a déjà triés.
Codex. L’agent OpenAI, le même métier côté terminal et app. Astra y est depuis début septembre. Les plafonds sont des fourchettes / 5 h, partagées avec ChatGPT Work. Plus (20 $) : Astra 5–45 messages locaux / 5 h. Pro 5× (100 $) : 25–225. Pro 20× (200 $) : 100–900. Sol, Terra, Luna tiennent plus longtemps. L’app officielle ressemble à un chat de projet, pas à un IDE.
Crédit : OpenAI, openai.com/codex (ouvre openai.com dans un nouvel onglet). Visuel produit de l’application Codex. Pas une image générée.
JetBrains, dans un second papier du 26 août, demande quelle part du code du mois a été entièrement écrite par des agents : environ 47 % en moyenne, 38 % avec de l’aide, 27 % à la main (les parts se chevauchent selon les répondants). Chez les gens qui mettent Codex en tête, 42 % disent que les agents écrivent plus de 80 % du code. Chez Claude Code, 32 %. Cursor est proche de Claude Code (28 % au-dessus de 80 %). Ce n’est pas un banc. C’est de l’auto-déclaration.
Ce que ça ne tranche pas
Un score CursorBench ne dit pas si l’on préfère rester dans l’éditeur ou coller un agent dans un terminal. Un taux d’adoption JetBrains, calé en juillet, ne voit ni Astra, ni le nouveau quota Claude Code, ni Projects. Copilot a encore la notoriété. Cursor a encore la fenêtre. Codex a la pente. Claude Code a le volume.
Attention
CursorBench 4.0 est un banc Cursor, tâches privées, configs « max » souvent les plus chères. Composer 2.5 à 27,7 % n’interdit pas d’y coller Fable 5.1. Les 39 % Claude Code sont un usage au travail, pas un monopole. Astra n’est pas dans le tableau 4.0 public du 10–18 septembre.
Trois surfaces. Un métier : faire écrire, relire, merger. Le modèle se choisit dans l’outil, pas à la place de l’outil. Le quota, lui, se lit dans /usage.
Sources
- JetBrains Research, AI Coding Agents: Adoption Trends, 18 août 2026 (ouvre blog.jetbrains.com dans un nouvel onglet)
- JetBrains Research, How Much Code Do Developers Really Let Agents Write?, 26 août 2026 (ouvre blog.jetbrains.com dans un nouvel onglet)
- Cursor, CursorBench 4.0 (ouvre cursor.com dans un nouvel onglet)
- Cursor, Introducing Projects, 10 septembre 2026 (ouvre cursor.com dans un nouvel onglet)
- Cursor forum, Claude Fable 5.1, 1er septembre 2026 (ouvre forum.cursor.com dans un nouvel onglet)
- OpenAI, Codex (ouvre openai.com dans un nouvel onglet)
- OpenAI, tarifs Codex (ouvre learn.chatgpt.com dans un nouvel onglet)
- OpenAI, GPT-6 Astra (ouvre openai.com dans un nouvel onglet)
- Anthropic, Claude Code (ouvre anthropic.com dans un nouvel onglet)
Laisser un avis
Avis des lecteurs
Aucun avis publié pour le moment.
À lire aussi
- Agents API : le harnais Codex, facturé au tokenLe 10 septembre 2026, OpenAI ouvre l’Agents API en beta. C’est le harnais Codex, en API. Pas de frais séparés : tokens, outils, et 0,03–1,92 $ / 20 min de sandbox. Résidence US only, pas de ZDR.
- Codex : le quota 20× n’est pas un contratLe 20 septembre 2026, OpenAI dit encore que les messages Codex / 5 h « ne sont pas des plafonds fixes ». Pro 20× : Astra 100–900. Les nouvelles souscriptions à 200 $ sont en pause depuis le 10. Le compteur saute ; les resets de Tibo tiennent le forfait. L’API et les plans chinois facturent au token.
- Grok 4.6 à 2 $ / 6 $ le million : le cache à 0,50 $ et le palier 200kSur l’API xAI, Grok 4.6 reste à 2 $ / 6 $ le million sous 200k jetons de prompt. Le cache lu passe à 0,50 $, contre 0,30 $ sur 4.5. Au palier 200k, toute la requête double. Fable 5.1 : 10 $ / 50 $, cache 0,25 $.